Claude Fable 5.2 intresserar mig eftersom jag redan använder Fable för arbete som är svårt att dela upp i små, isolerade frågor. Jag använder det för att bygga komplexa planer, bolla idéer, undersöka ett problem och arbeta igenom kodbaser där en funktion berör flera delar av systemet.
En liten funktion är sällan den svåra delen. Den svåra delen är att förstå vad mer som måste ändras och vad som måste fortsätta fungera.
Anthropic släppte Fable 5.2 den 9 november 2026. De tidiga resultaten ser lovande ut för den typen av arbete. De visar också varför jag inte skulle skicka varje uppgift till det med maximal ansträngning. Detta är en lanseringsanalys byggd kring mitt befintliga Fable-arbetsflöde, inte ett påstående om att jag självständigt har benchmarkat 5.2.
Research kontrollerad den 10 november 2026. Hero-bilden är en AI-genererad redaktionell illustration, inte ett Anthropic-gränssnitt. Diagrammen nedan använder registrerade utvärderingsdata, inte genererade siffror.
Vad är nytt i Claude Fable 5.2?
Fable 5.2 är Anthropics nya modell för krävande resonemang och långvarigt tekniskt arbete. Dess specifikationer anger ett kontextfönster på en miljon tokens, upp till 128 000 output-tokens samt stöd för text- och bildinput med text som output. Ett stort kontextfönster innebär att den kan ta emot omfattande material; det garanterar inte att den använder varje detalj korrekt. Claude Fable 5.2 specifications
Anthropic säger att output-genereringen är upp till 30 % snabbare än i Fable 5.1. Det är ett påstående om generering av tokens, inte ett löfte om att ett helt projekt blir klart 30 % snabbare.
Fable och Mythos 5.2 delar den underliggande modellen, men skiljer sig åt vad gäller skyddsåtgärder och åtkomst. Mythos är avsett för verifierade organisationer inom områden som cybersäkerhet och biovetenskap. Ett resultat som endast gäller Mythos bör inte presenteras som något som alla Fable-användare kan återskapa. Anthropic: Fable 5.2 and Mythos 5.2 launch
Varför jag använder Fable när en funktion sträcker sig över hela kodbasen
Föreställ dig att du lägger till ett godkännandesteg i ett arbetsflöde för dokumentuppladdning. Knappen är enkel att beskriva. En tillförlitlig implementation kräver mer eftertanke.
API:t måste kontrollera vem som får godkänna. Databasen måste lagra beslutet. Ett bakgrundsjobb måste undvika att skicka samma avisering två gånger. Gränssnittet behöver tillstånden väntande, godkänt och misslyckat. Tester måste täcka att två personer agerar samtidigt.
Jag vill att modellen ska förstå de kopplingarna innan den börjar redigera. Att rätta varje fil separat kan lämna efter sig en funktion som fungerar på en skärm men misslyckas någon annanstans.
Planera och utmana en idé
Det är här jag tycker om att använda Fable som diskussionspartner. Jag kan beskriva resultatet, utforska olika angreppssätt och be den utmana antagandena. Jag vill ha en plan som identifierar beroenden och fallgropar, snarare än en lång uppgiftslista som låter organiserad.
Modellen bör till exempel förklara om godkännandet hör hemma i det befintliga arbetsflödet eller kräver en separat tjänst. Den bör också kunna säga till mig att den mindre ändringen räcker.
Research som påverkar en implementation
Research är användbar när den förändrar ett beslut. Jag vill att modellen jämför dokumentation, förklarar avvägningar och skiljer en bekräftad begränsning från en gissning.
Den standard jag bryr mig om är praktisk: kan jag följa källan, kontrollera påståendet och förstå vad som fortfarande är osäkert? En självsäker sammanfattning utan sådana belägg räcker inte, oavsett modell.
Vad visar coding-benchmarksen?
Anthropics lanseringstabell rapporterar 49,1 % på FrontierCode 2.0, jämfört med 32,4 % för Fable 5.1 och 45,5 % för Opus 5.5. De två Fable-resultaten använder xhigh effort; Opus använder max. Detta är utvalda resultat med maximal ansträngning, inte en jämförelse med samma kostnad.
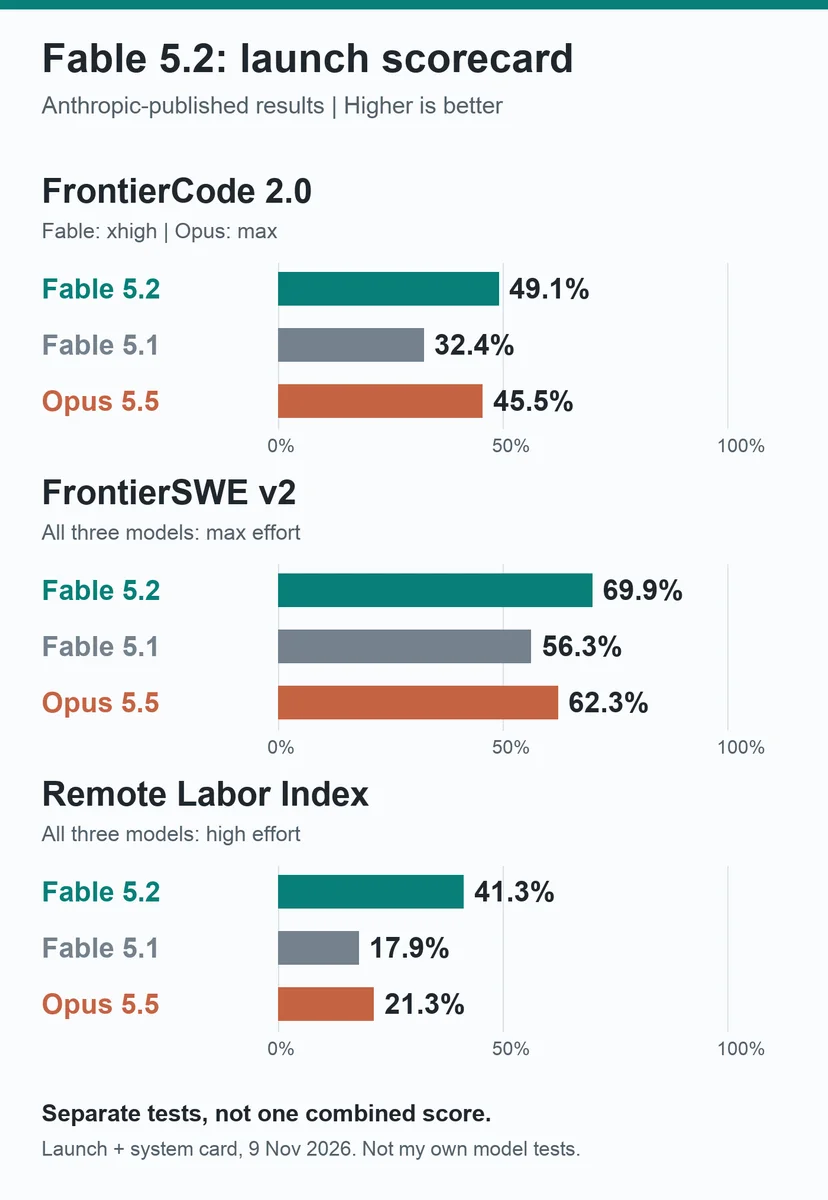
Varje panel mäter en annan typ av uppgift. Ta inte genomsnittet av procentsiffrorna. FrontierSWE v2 använder max effort; Remote Labor Index-resultaten för Claude använder high effort, en kontext på 200 000 tokens och en svarsgräns på 32 000 tokens, enligt systemkortet. Anthropic system card, capabilities section
FrontierSWE är särskilt relevant för mina intressen. Författarna beskriver 34 långa engineering- och researchuppgifter, med en budget på 20 timmar per uppgift. Det ligger närmare uthållig problemlösning än att slutföra en kort funktion. Det är fortfarande en specifik testmiljö, inte en prognos för mina repositorier. FrontierSWE v2 methodology
Resultatet från Remote Labor Index är också lätt att överdriva. Ett resultat på 41,3 % för dessa projekt betyder inte att Fable kan ersätta 41,3 % av jobben. Det är ett resultat på en definierad uppsättning leveranser.
Vad kommer oberoende testare fram till?
De första offentliga testerna pekar på stark kapacitet med viktiga begränsningar. De utgör ännu inte en bred konsensus om produktionskodbaser.
Artificial Analysis listar Fable 5.2 med ett avrundat Intelligence Index-resultat på 65 vid max effort i den ögonblicksbild jag kontrollerade. Resultatet vid high effort är 62. Kostnadsskillnaden är betydande, vilket nästa diagram visar. Detta är en separat utvärderingssvit från Anthropics lanseringstabell. Artificial Analysis: model results
Spring Prompt genomförde sina egna företagstester den 10 november. Fable ledde deras tester av enkätanalys och simulerade reklambudgetar, men GPT-6.1 Sol var något mer tillförlitlig för faktabaserade produktlistningar och mycket billigare per listning. De flesta av dessa tester kördes en gång; produktlistningstesterna använde tre upprepningar. Teamet säger uttryckligen att de inte benchmarkade coding-agenter. Jag tolkar detta som ett tidigt skäl att testa analysintensivt arbete, inte som ett bevis på bättre mjukvarumigreringar. Spring Prompt: Fable 5.2 review and test limits
Simon Willison hittade en användbar varning i ett litet experiment med SVG-generering. Xhigh producerade ett resultat, medan max använde sin gräns på 128 000 tokens till att tänka och inte returnerade någon bild. Det är ett rapporterat experiment, inte en generell felfrekvens. Det räcker för att ifrågasätta antagandet att den högsta inställningen alltid ger det bästa svaret. Simon Willison: first Fable 5.2 experiments
Hur mycket kostar det, och vilken effort-nivå är rimlig?
Standardpriset för API:t är 8 dollar per miljon input-tokens och 40 dollar per miljon output-tokens. Det är 20 % lägre än Fable 5.1:s 10/50 dollar. Opus 5.5 kostar 4/20 dollar. Cache-läsningar för Fable 5.2 kostar 0,20 dollar per miljon tokens; cache-skrivningar har separata avgifter. Detta är API-priser, inte inkluderade prenumerationsmängder. Anthropic pricing
Det valfria fast-läget kostar 16/80 dollar per miljon input/output-tokens. Anthropic hävdar upp till 2,5 gånger snabbare tokengenerering i det läget. Snabbare output och ett lägre pris per token är separata saker från den slutliga kostnaden för att slutföra en uppgift.
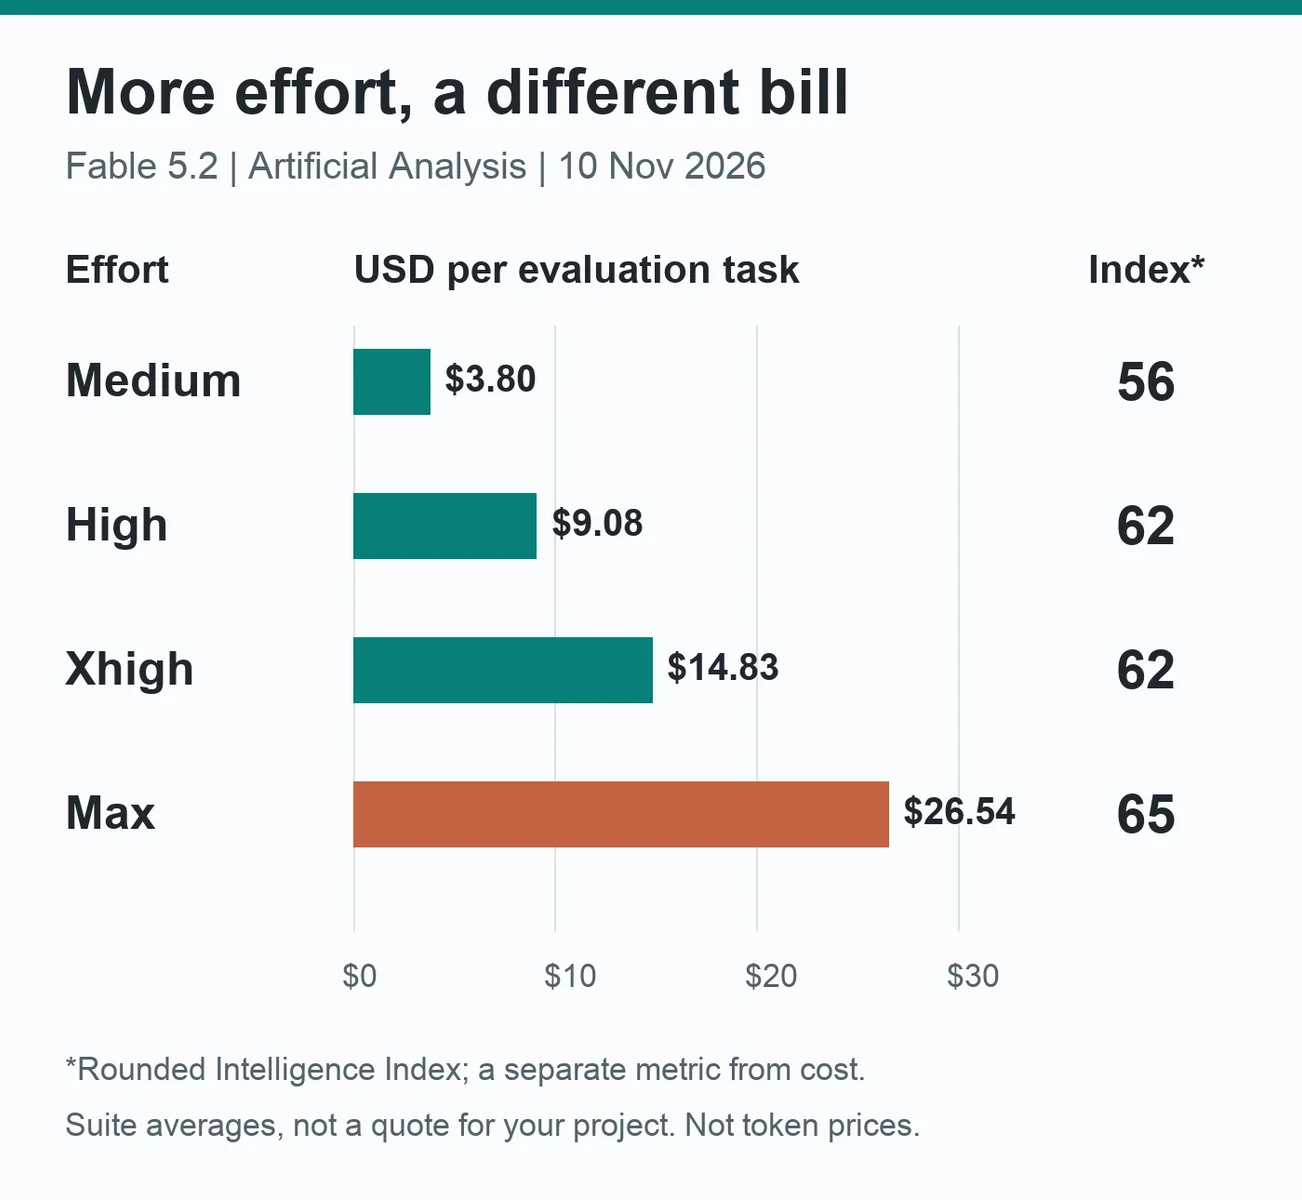
Artificial Analysis-ögonblicksbild, 10 november: medium 3,80 dollar, high 9,08 dollar, xhigh 14,83 dollar och max 26,54 dollar per Intelligence Index-uppgift. Detta är genomsnitt från en utvärderingssvit, inte offerter för en funktion eller ett researchprojekt. De avrundade indexresultaten är 56, 62, 62 respektive 65. Artificial Analysis: effort and cost comparison
Högre effort behöver en anledning
Anthropics API använder high som standard för Fable 5.2, medan lanseringssidan säger att Claude-appar och Claude Code använder medium som standard. Thinking är alltid aktiverat. Effort-inställningen styr hur mycket arbete modellen lägger på sitt svar; det är inte bara en växel för längre svar.
Anthropics guide för effort rekommenderar high som startpunkt för API:t och reserverar max för sällsynta uppgifter där tid och tokens spelar mindre roll. Jag skulle jämföra inställningarna på representativt arbete och sedan bara betala mer när resultatet motiverar det. Claude effort guidance
Hur jag skulle strukturera en komplex coding-session
Min utgångspunkt skulle vara ett tydligt resultat och en begäran om att inspektera det befintliga systemet. Jag skulle vilja ha fyra saker från sessionen:
En startprompt kan vara:
text Innan du redigerar, spåra den här funktionen genom den befintliga kodbasen. Kartlägg dess beroenden och förklara de viktigaste fallgroparna. Föreslå den minsta kompletta ändringen och de tester som skulle upptäcka en trasig implementation. Bevara orelaterat arbete. Fråga innan migrering, publicering eller deployment. Rapportera därefter vad som ändrades, vad du verifierade och vad som fortfarande är overifierat.
Jag skulle inte kopiera prompts som ger modellen obegränsat ägarskap över en kunds kodbas. Anthropics prompting-guide varnar för att formuleringar om ägarskap kan uppmuntra till extra ändringar, även när andra instruktioner begränsar omfattningen. Det är ett skäl att göra gränserna tydliga och inspektera diffen. Prompting Claude Fable 5.2
En billigare modell kan också hantera rutinmässiga steg medan Fable hjälper till med svåra beslut. Claude Codes advisor-verktyg stöder den lösningen, med villkor för åtkomst och fakturering. Rådgivning förbrukar fortfarande tokens; delegering är inte gratis. Claude Code advisor documentation
Min slutsats: använd det där förståelse av systemet spelar roll
Jag är intresserad av Fable 5.2 eftersom planering, research och ändringar som sträcker sig över kodbasen redan är anledningarna till att jag vänder mig till Fable. Jag vill ha hjälp med att koppla ihop delarna och utmana ett angreppssätt innan jag lägger tid på implementationen.
Det gör det inte till mitt automatiska val för varje redigering. Anthropic rekommenderar fortfarande att man börjar med Opus 5.5 för det mesta coding- och kunskapsarbetet. Min Opus 5.5 overview och tidigare Fable 5.1 review ger kontext till det valet.
För det svåra arbetet vill jag ha en tydlig plan, en sammanhängande implementation och bevis på att den fungerar. Jag skulle behålla de oberoende kontroller som beskrivs i mitt multi-agent code review workflow, i stället för att behandla en starkare modell som sin egen slutliga granskare.
Fable 5.2 verkar vara värd att testa på de svårare uppgifterna. Den användbara frågan är om den lämnar mig med mindre återstående arbete och ett resultat som jag kan verifiera.