Claude Fable 5.2 me interessa porque já uso Fable para trabalhos difíceis de dividir em pequenas perguntas isoladas. Uso-o para criar planos complexos, trocar ideias, pesquisar um problema e trabalhar em bases de código nas quais um recurso afeta várias partes do sistema.
Uma função pequena raramente é a parte difícil. A parte difícil é entender o que mais precisa mudar e o que deve continuar funcionando.
A Anthropic lançou o Fable 5.2 em 9 de novembro de 2026. Os primeiros resultados parecem promissores para esse tipo de trabalho. Eles também mostram por que eu não enviaria todas as tarefas para ele com esforço máximo. Esta é uma análise do lançamento baseada no meu fluxo de trabalho atual com Fable, não uma afirmação de que fiz benchmarks independentes do 5.2.
Pesquisa verificada em 10 de novembro de 2026. A imagem principal é uma ilustração editorial gerada por AI, não uma interface da Anthropic. Os gráficos abaixo usam dados de avaliações registrados, não números gerados.
O que há de novo no Claude Fable 5.2?
Fable 5.2 é o novo modelo da Anthropic para raciocínio exigente e trabalho técnico de longa duração. Suas especificações listam uma janela de contexto de um milhão de tokens, até 128.000 tokens de saída e suporte para entrada de texto e imagem com saída de texto. Uma janela de contexto grande significa que ele pode aceitar uma quantidade substancial de material; isso não garante que usará todos os detalhes corretamente. Especificações do Claude Fable 5.2
A Anthropic afirma que a geração de saída é até 30% mais rápida que a do Fable 5.1. Essa é uma afirmação sobre a geração de tokens, não uma promessa de que um projeto inteiro terminará 30% mais rápido.
Fable e Mythos 5.2 compartilham o modelo subjacente, mas diferem em salvaguardas e acesso. Mythos é destinado a organizações verificadas em áreas como cybersecurity e life sciences. Um resultado exclusivo do Mythos não deve ser apresentado como algo que todo usuário do Fable pode reproduzir. Anthropic: lançamento do Fable 5.2 e Mythos 5.2
Por que uso Fable quando um recurso abrange toda a base de código
Imagine adicionar uma etapa de aprovação a um fluxo de upload de documentos. É fácil descrever o botão. Uma implementação confiável exige mais reflexão.
A API precisa verificar quem pode aprovar. O banco de dados precisa armazenar a decisão. Um job em segundo plano precisa evitar o envio da mesma notificação duas vezes. A interface precisa de estados pendente, aprovado e com falha. Os testes precisam cobrir duas pessoas agindo ao mesmo tempo.
Quero que o modelo entenda essas conexões antes de começar a editar. Corrigir cada arquivo separadamente pode deixar um recurso que funciona em uma tela, mas falha em outro lugar.
Planejando e questionando uma ideia
É aqui que gosto de usar Fable como parceiro de discussão. Posso descrever o resultado, explorar diferentes abordagens e pedir que ele questione as premissas. Quero um plano que identifique dependências e casos de falha, em vez de uma longa lista de tarefas que parece organizada.
Por exemplo, o modelo deve explicar se a aprovação pertence ao fluxo existente ou se precisa de um serviço separado. Ele também deve ser capaz de me dizer que a mudança menor é suficiente.
Pesquisa que orienta uma implementação
A pesquisa é útil quando muda uma decisão. Quero que o modelo compare documentação, explique trade-offs e separe uma limitação confirmada de uma suposição.
O padrão que considero importante é prático: consigo seguir a fonte, verificar a afirmação e entender o que continua incerto? Um resumo confiante sem essas evidências não é suficiente, independentemente do modelo.
O que os benchmarks de codificação mostram?
A tabela de lançamento da Anthropic informa 49,1% no FrontierCode 2.0, contra 32,4% do Fable 5.1 e 45,5% do Opus 5.5. Os dois resultados do Fable usam esforço xhigh; o Opus usa max. Esses são resultados selecionados com o melhor esforço, não uma comparação de custo equivalente.
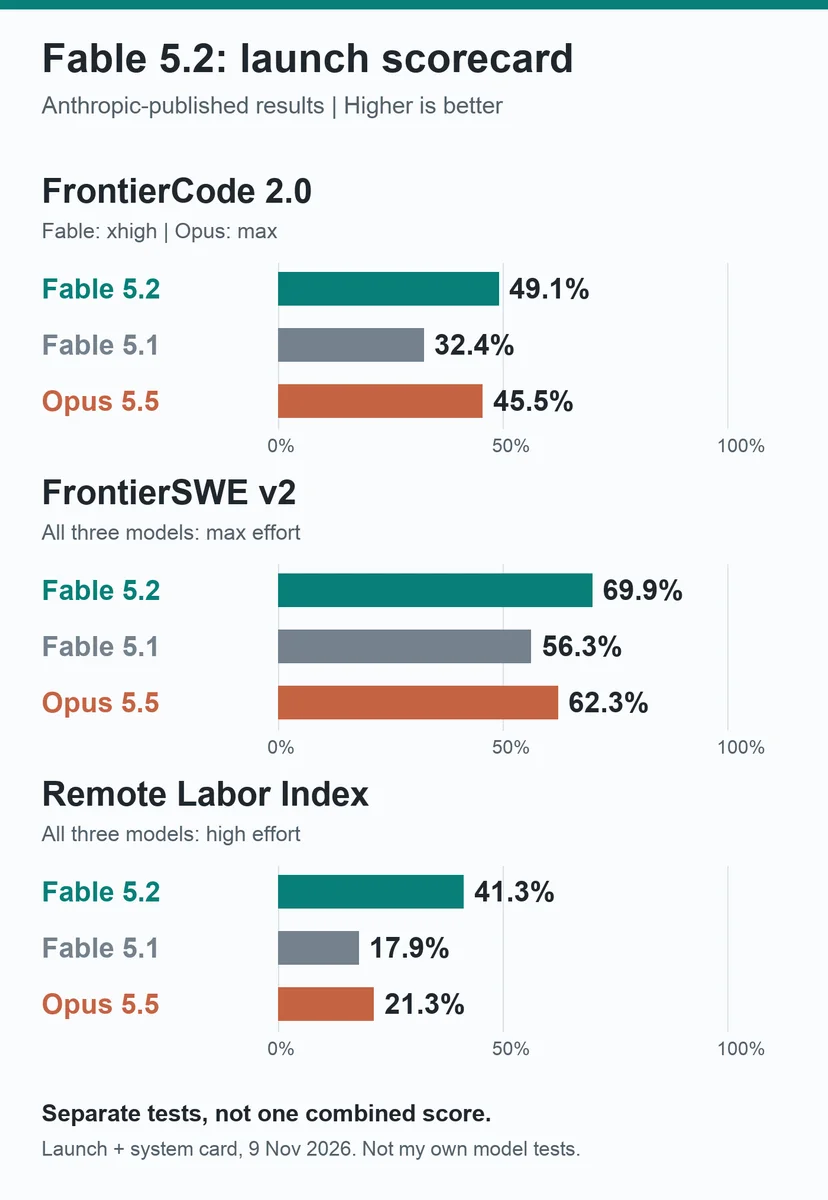
Cada painel mede uma tarefa diferente. Não faça uma média das porcentagens. FrontierSWE v2 usa esforço max; as execuções do Claude no Remote Labor Index usam esforço high, um contexto de 200.000 tokens e um limite de resposta de 32.000 tokens, de acordo com o system card. System card da Anthropic, seção de capacidades
FrontierSWE é particularmente relevante para meus interesses. Seus autores descrevem 34 tarefas longas de engenharia e pesquisa, com um orçamento de 20 horas por tarefa. Isso se aproxima mais da resolução sustentada de problemas do que da conclusão de uma única função curta. Ainda é um ambiente de teste específico, não uma previsão para meus repositórios. Metodologia do FrontierSWE v2
O resultado do Remote Labor Index também é fácil de exagerar. Uma pontuação de 41,3% nesses projetos não significa que Fable possa substituir 41,3% dos empregos. É um resultado em um conjunto definido de entregas.
O que os testadores independentes estão descobrindo?
Os primeiros testes públicos apontam para uma capacidade forte, com limitações importantes. Eles ainda não constituem um consenso amplo sobre bases de código de produção.
Artificial Analysis lista o Fable 5.2 com uma pontuação arredondada de 65 no Intelligence Index, com esforço max, no snapshot que consultei. O resultado com esforço high é 62. A diferença de custo é substancial, como mostra o próximo gráfico. Esta é uma suíte de avaliação separada da tabela de lançamento da Anthropic. Artificial Analysis: resultados do modelo
Spring Prompt realizou seus próprios testes de negócios em 10 de novembro. Fable liderou seus testes de análise de pesquisas e de orçamento publicitário simulado, mas GPT-6.1 Sol foi um pouco mais confiável em listagens factuais de produtos e muito mais barato por listagem. A maioria desses testes foi executada uma vez; os testes de listagem de produtos usaram três repetições. A equipe afirma explicitamente que não fez benchmark de agentes de codificação. Interpreto isso como uma razão inicial para testar trabalhos focados em análise, não como prova de migrações de software melhores. Spring Prompt: análise do Fable 5.2 e limites dos testes
Simon Willison encontrou um alerta útil em um pequeno experimento de geração de SVG. Xhigh produziu um resultado, enquanto max gastou seu limite de 128.000 tokens pensando e não retornou nenhuma imagem. Esse é um experimento relatado, não uma taxa geral de falha. É suficiente para questionar a suposição de que a configuração mais alta sempre produz a melhor resposta. Simon Willison: primeiros experimentos com o Fable 5.2
Quanto custa e qual nível de esforço faz sentido?
O preço padrão da API é de US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída. Isso representa 20% menos que os US$ 10/US$ 50 do Fable 5.1. Opus 5.5 custa US$ 4/US$ 20. Leituras de cache para Fable 5.2 custam US$ 0,20 por milhão de tokens; gravações de cache têm cobranças separadas. Esses são preços da API, não franquias de assinatura. Preços da Anthropic
O modo rápido opcional custa US$ 16/US$ 80 por milhão de tokens de entrada/saída. A Anthropic afirma que esse modo oferece geração de tokens até 2,5 vezes mais rápida. Uma saída mais rápida e um preço menor por token são coisas separadas do custo final de concluir uma tarefa.
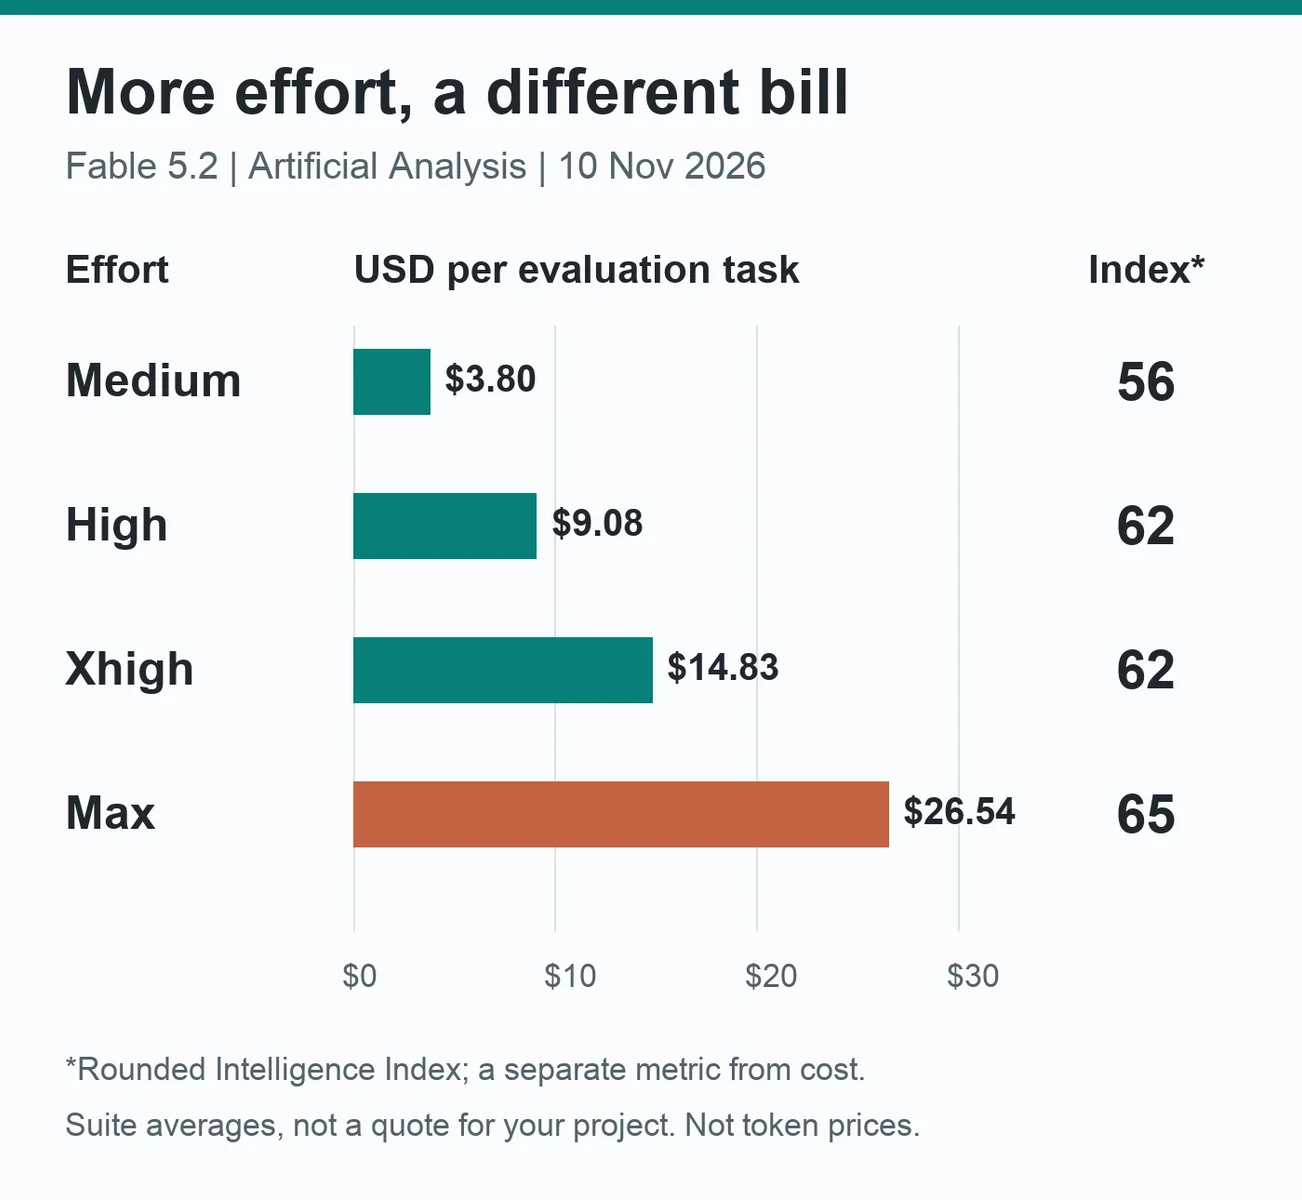
Snapshot do Artificial Analysis, 10 de novembro: medium US$ 3,80, high US$ 9,08, xhigh US$ 14,83 e max US$ 26,54 por tarefa do Intelligence Index. Essas são médias da suíte de avaliação, não cotações para um recurso ou projeto de pesquisa. As pontuações arredondadas do índice são 56, 62, 62 e 65, respectivamente. Artificial Analysis: comparação de esforço e custo
Um esforço maior precisa de uma justificativa
A API da Anthropic usa high como padrão para o Fable 5.2, enquanto sua página de lançamento informa que os aplicativos Claude e o Claude Code usam medium como padrão. O pensamento está sempre ativado. A configuração de esforço controla quanto trabalho o modelo dedica à resposta; não é simplesmente uma opção para respostas mais longas.
O guia de esforço da Anthropic recomenda high como ponto de partida na API e reserva max para tarefas raras nas quais tempo e tokens importam menos. Eu compararia as configurações em trabalhos representativos e só pagaria mais quando o resultado justificasse. Orientações sobre esforço do Claude
Como eu estruturaria uma sessão complexa de codificação
Meu ponto de partida seria um resultado claro e um pedido para inspecionar o sistema existente. Eu esperaria quatro coisas da sessão:
Um prompt inicial poderia ser:
text Antes de editar, rastreie este recurso pela base de código existente. Mapeie suas dependências e explique os principais casos de falha. Proponha a menor mudança completa e os testes que detectariam uma implementação quebrada. Preserve o trabalho não relacionado. Pergunte antes de fazer migrações, publicar ou realizar deploy. Depois, informe o que mudou, o que foi verificado e o que continua sem verificação.
Eu não copiaria prompts que dão ao modelo controle irrestrito sobre a base de código de um cliente. O guia de prompting da Anthropic alerta que uma linguagem de propriedade pode incentivar mudanças extras, mesmo quando outras instruções limitam o escopo. Essa é uma razão para deixar os limites explícitos e inspecionar o diff. Fazendo prompting do Claude Fable 5.2
Um modelo mais barato também pode lidar com etapas rotineiras enquanto Fable ajuda com decisões difíceis. A ferramenta advisor do Claude Code oferece suporte a esse arranjo, com condições de acesso e cobrança. Os conselhos ainda consomem tokens; delegar não é gratuito. Documentação do advisor do Claude Code
Minha opinião: use-o quando entender o sistema for importante
Tenho interesse no Fable 5.2 porque planejamento, pesquisa e mudanças que atravessam a base de código já são os motivos pelos quais recorro ao Fable. Quero ajuda para conectar as partes e questionar uma abordagem antes de gastar tempo implementando-a.
Isso não faz dele minha escolha automática para toda edição. A Anthropic ainda recomenda começar a maior parte do trabalho de codificação e conhecimento com Opus 5.5. Minha visão geral do Opus 5.5 e a análise anterior do Fable 5.1 oferecem contexto para essa escolha.
Para o trabalho difícil, quero um plano claro, uma implementação coerente e evidências de que funciona. Eu manteria as verificações independentes descritas no meu fluxo de revisão de código com múltiplos agentes, em vez de tratar um modelo mais forte como seu próprio revisor final.
Fable 5.2 parece valer a pena ser testado nessas tarefas mais difíceis. A pergunta útil é se ele me deixa com menos trabalho pendente e um resultado que posso verificar.