Claude Fable 5.2 に関心を持っているのは、すでに Fable を、細かく分割して独立した質問にするのが難しい作業に使っているからです。複雑な計画を立てたり、アイデアを出し合ったり、問題をリサーチしたり、1つの機能がシステムの複数箇所に影響するコードベースを調べたりするために使っています。
小さな関数が難しい部分になることは、ほとんどありません。難しいのは、ほかに何を変更する必要があるのか、そして何を動作させ続けなければならないのかを理解することです。
Anthropic は 2026年11月9日に Fable 5.2 をリリースしました。初期結果は、この種の作業に有望なものに見えます。同時に、すべてのタスクを最大の effort で実行すべきではない理由も示しています。これは、私が現在使っている Fable のワークフローを軸にしたローンチ分析であり、私自身が 5.2 のベンチマークを独自に実施したという主張ではありません。
リサーチ確認日:2026年11月10日。ヒーロー画像は AI が生成したエディトリアルイラストであり、Anthropic のインターフェースではありません。以下のチャートは、生成された数値ではなく、記録された評価データを使用しています。
Claude Fable 5.2 の新機能は?
Fable 5.2 は、要求の厳しい推論や長時間にわたる技術作業向けの Anthropic の新しいモデルです。仕様には、100万トークンのコンテキストウィンドウ、最大128,000出力トークン、テキストおよび画像入力とテキスト出力への対応が記載されています。大きなコンテキストウィンドウがあれば大量の資料を受け取れますが、すべての詳細を正しく使えることが保証されるわけではありません。Claude Fable 5.2 specifications
Anthropic によると、出力生成は Fable 5.1 より最大30%高速です。これはトークン生成についての主張であり、プロジェクト全体が30%早く完了するという約束ではありません。
Fable と Mythos 5.2 は基盤となるモデルを共有していますが、安全対策とアクセス方法が異なります。Mythos は、サイバーセキュリティやライフサイエンスなどの分野における認証済み組織向けです。Mythos 専用の結果を、すべての Fable ユーザーが再現できるものとして提示すべきではありません。Anthropic: Fable 5.2 and Mythos 5.2 launch
機能がコードベース全体にまたがるときに Fable を使う理由
ドキュメントアップロードのワークフローに承認ステップを追加するとします。ボタンについて説明するのは簡単です。しかし、信頼できる実装には、より多くの検討が必要です。
API は誰が承認できるのかを確認しなければなりません。データベースには判断結果を保存する必要があります。バックグラウンドジョブは、同じ通知を2回送信しないようにしなければなりません。インターフェースには、保留中、承認済み、失敗の状態が必要です。テストでは、2人が同時に操作するケースをカバーしなければなりません。
編集を始める前に、モデルにはそれらのつながりを理解してほしいと思っています。各ファイルを個別に修正すると、ある画面では動作するものの、別の場所では失敗する機能が残る可能性があります。
計画を立て、アイデアに異議を唱える
ここで、Fable を議論の相手として使うのが好きです。実現したい結果を説明し、異なるアプローチを検討し、前提に異議を唱えるよう求められます。整理されているように見える長いタスクリストではなく、依存関係と失敗ケースを特定した計画が欲しいのです。
たとえば、承認を既存のワークフローに組み込むべきなのか、それとも別のサービスが必要なのかをモデルに説明してほしいと思います。また、より小さな変更で十分だと判断できることも重要です。
実装に役立つリサーチ
リサーチは、意思決定を変えるときに役立ちます。ドキュメントを比較し、トレードオフを説明し、確認済みの制限と推測を区別してほしいと思っています。
私が重視する基準は実用的なものです。情報源をたどり、主張を確認し、何がまだ不確かなのかを理解できるでしょうか。その証拠がない自信満々の要約は、モデルにかかわらず十分ではありません。
コーディングベンチマークは何を示しているのか?
Anthropic のローンチ時の表では、FrontierCode 2.0 で49.1%と報告されています。Fable 5.1 は32.4%、Opus 5.5 は45.5%でした。2つの Fable の結果は xhigh effort を使用し、Opus は max を使用しています。これらは選択された最大 effort の結果であり、同一コストでの比較ではありません。
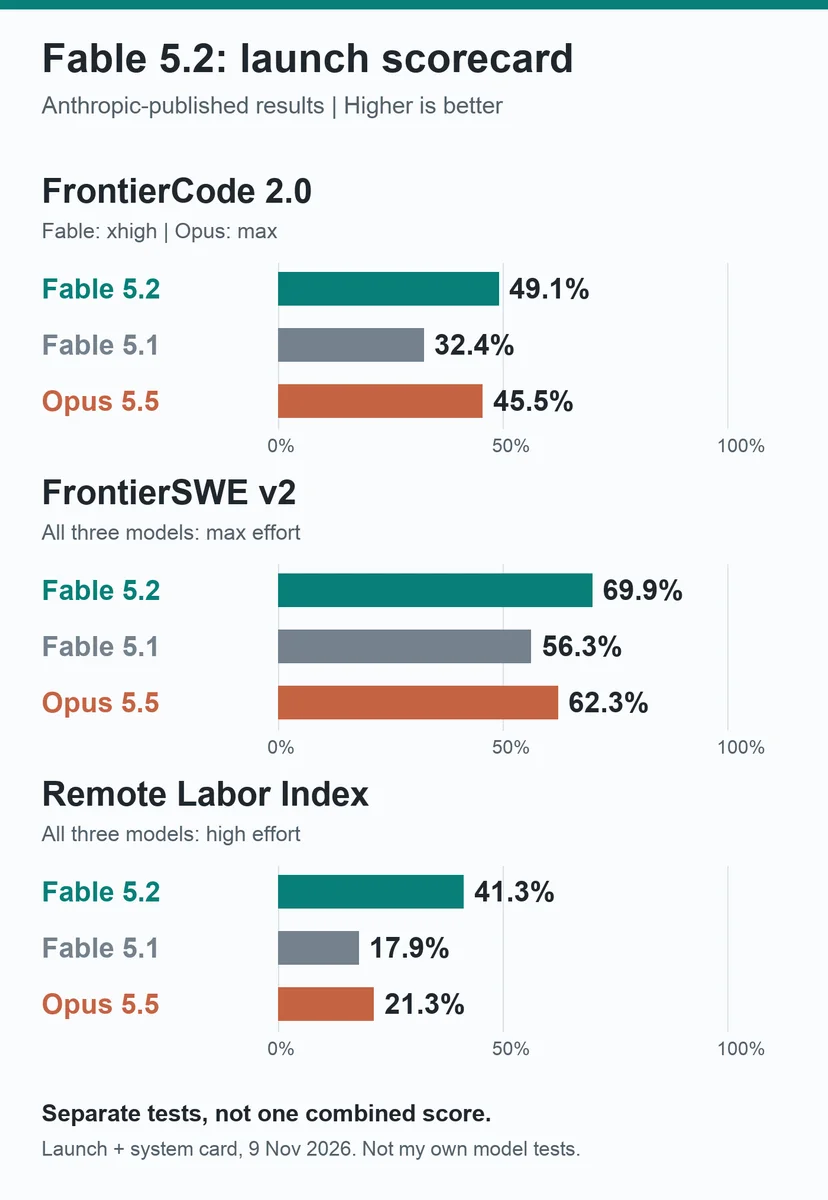
各パネルは異なるタスクを測定しています。パーセンテージを平均しないでください。FrontierSWE v2 は max effort を使用しています。system card によると、Remote Labor Index の Claude 実行では high effort、200,000トークンのコンテキスト、32,000トークンのレスポンス上限を使用しています。Anthropic system card, capabilities section
FrontierSWE は、私の関心に特に関連しています。その著者たちは、34件の長時間にわたるエンジニアリングおよびリサーチタスクを説明しており、各タスクには20時間の予算が設定されています。これは、短い関数を1つ完成させるよりも、継続的な問題解決に近いものです。それでも、特定のテスト環境での結果であり、私のリポジトリに対する予測ではありません。FrontierSWE v2 methodology
Remote Labor Index の結果も、誇張されやすいものです。これらのプロジェクトで41.3%というスコアだったからといって、Fable が仕事の41.3%を置き換えられるという意味ではありません。定義された成果物の集合に対する結果です。
独立したテスターは何を見つけているのか?
最初の公開テストは、重要な限界を伴いながらも高い能力を示しています。ただし、まだ本番のコードベースについて幅広いコンセンサスに達したわけではありません。
Artificial Analysis は、私が確認したスナップショットで、Fable 5.2 の Intelligence Index スコアを max effort で丸めて65としています。high-effort の結果は62です。次のチャートが示すように、コスト差は大きなものです。これは Anthropic のローンチ時の表とは別の評価スイートです。Artificial Analysis: model results
Spring Prompt は11月10日に独自のビジネステストを実施しました。Fable はアンケート分析と広告予算のシミュレーションテストで首位になりましたが、事実に基づく商品リストでは GPT-6.1 Sol のほうがわずかに信頼性が高く、商品1件あたりのコストは大幅に安価でした。これらのテストの大半は1回だけ実行され、商品リストのテストでは3回繰り返されました。チームは、コーディングエージェントのベンチマークは実施していないと明確に述べています。私はこれを、分析中心の作業をテストする初期の理由とは捉えていますが、ソフトウェア移行が優れている証拠とは考えていません。Spring Prompt: Fable 5.2 review and test limits
Simon Willison は、小規模な SVG 生成実験で有益な注意点を見つけました。Xhigh は結果を生成しましたが、max は128,000トークンの上限まで思考に費やし、画像を返しませんでした。これは報告された1つの実験であり、一般的な失敗率ではありません。しかし、最高設定が常に最良の回答を生むという前提に疑問を投げかけるには十分です。Simon Willison: first Fable 5.2 experiments
料金はいくらで、どの effort レベルが適切なのか?
標準 API 料金は、入力トークン100万件あたり8ドル、出力トークン100万件あたり40ドルです。これは Fable 5.1 の10ドル/50ドルより20%安価です。Opus 5.5 は4ドル/20ドルです。Fable 5.2 のキャッシュ読み取りはトークン100万件あたり0.20ドルで、キャッシュ書き込みには別途料金がかかります。これらは API 料金であり、サブスクリプションの利用枠ではありません。Anthropic pricing
オプションの fast mode は、入力/出力トークン100万件あたり16ドル/80ドルです。Anthropic は、このモードでトークン生成が最大2.5倍高速になると主張しています。出力が速いことと、トークン単価が安いことは、タスク完了にかかる最終コストとは別の要素です。
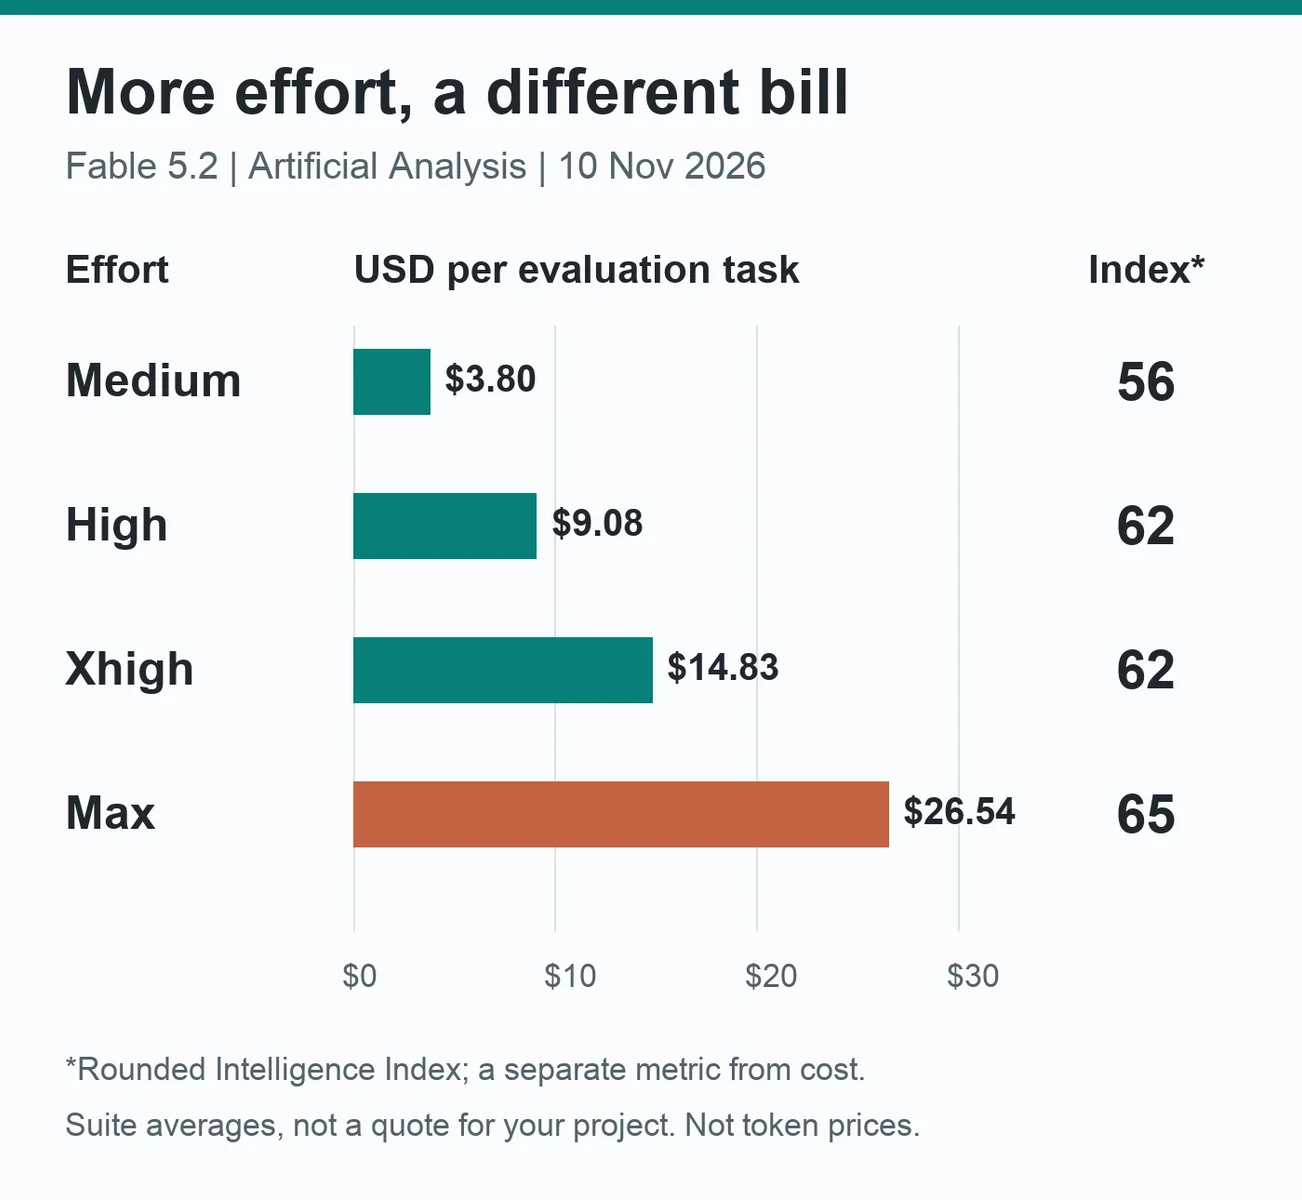
Artificial Analysis の11月10日時点のスナップショット:Intelligence Index のタスク1件あたり、medium は3.80ドル、high は9.08ドル、xhigh は14.83ドル、max は26.54ドルです。これらは評価スイートの平均であり、機能やリサーチプロジェクトの見積もりではありません。丸められたインデックススコアは、それぞれ56、62、62、65です。Artificial Analysis: effort and cost comparison
高い effort には理由が必要
Anthropic の API では Fable 5.2 のデフォルトが high ですが、ローンチページによると Claude アプリと Claude Code のデフォルトは medium です。Thinking は常に有効です。effort 設定は、モデルがレスポンスにどれだけの作業を費やすかを制御するものであり、単に長い回答に切り替えるスイッチではありません。
Anthropic の effort ガイドは、API の開始点として high を推奨し、時間とトークンがあまり重要でないまれなタスクに max を取っておくよう勧めています。私なら、代表的な作業で設定を比較し、結果がそれに見合う場合にだけ追加料金を支払います。Claude effort guidance
複雑なコーディングセッションをどのように構成するか
私なら、明確な成果と、既存システムを調査するよう求めるところから始めます。セッションから得たいものは4つあります。
開始時のプロンプトは次のようになります。
text 編集する前に、既存のコードベース全体でこの機能を追跡してください。 依存関係を整理し、主な失敗ケースを説明してください。 完全な変更として最小限のものと、壊れた実装を検出できるテストを提案してください。 無関係な作業は維持してください。マイグレーション、公開、デプロイの前には確認してください。 最後に、変更した内容、検証した内容、まだ検証できていない内容を報告してください。
クライアントのコードベースをモデルに無制限に任せるプロンプトは、そのままコピーしないでしょう。Anthropic の prompting guide は、所有権に関する表現が、ほかの指示で範囲を制限していても追加の変更を促す可能性があると警告しています。だからこそ境界を明確にし、diff を確認する必要があります。Prompting Claude Fable 5.2
安価なモデルに定型的な手順を任せ、Fable には難しい判断を支援させることもできます。Claude Code の advisor tool は、アクセスと課金の条件付きで、その構成をサポートしています。助言にもトークンを消費するため、委任は無料ではありません。Claude Code advisor documentation
私の見解:システム理解が重要な場面で使う
Fable 5.2 に関心があるのは、計画、リサーチ、コードベースをまたぐ変更が、すでに Fable を使う理由になっているからです。実装に時間を使う前に、各部分をつなぎ、アプローチに異議を唱える手助けが欲しいのです。
だからといって、すべての編集で自動的に選ぶわけではありません。Anthropic は今でも、ほとんどのコーディングと知識作業では Opus 5.5 から始めることを推奨しています。私の Opus 5.5 overview と以前の Fable 5.1 review では、その選択についての背景を説明しています。
難しい作業では、明確な計画、一貫した実装、そして動作することを示す証拠が欲しいと思っています。より強力なモデル自体を最終レビュアーとみなすのではなく、私の multi-agent code review workflow で説明した独立したチェックを維持します。
Fable 5.2 は、そうした難しいタスクで試す価値がありそうです。重要なのは、より少ない未完了作業と、検証可能な結果を残してくれるかどうかです。