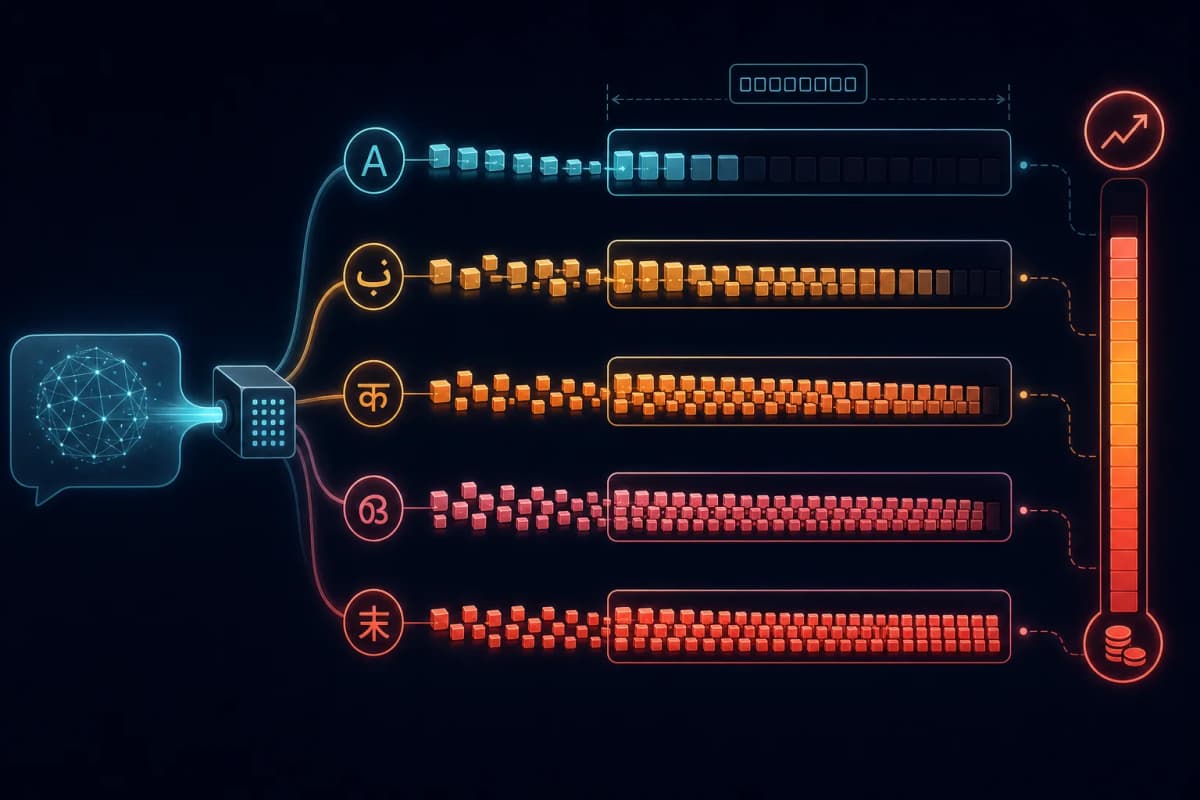
ضريبة توكنيزر LLM هي تكلفة قابلة للقياس وعقوبة سياقية. يمكن أن تحمل جملتان نفس المعنى ومع ذلك تستهلك عدد توكنات مختلف تمامًا لأنها تستخدم لغات مختلفة.
أظهرت دراسة في يوليو 2026 اختبار 997 جملة متوافقة عبر ستة توكنيزرات. مع ترميز `cl100k_base` القديم من OpenAI، كان لدى عشر لغات هندية متوسط ضريبة خصوبة الكلمات بمقدار 8.0 مرات مقارنة بالإنجليزية. وصلت اللغة المالايالامية إلى 13.04 مرة. خفضت `o200k_base` الجديدة المتوسط إلى 2.1 مرة. الدراسة لا تثبت أن التوكنيزر وحده يسبب إجابات أسوأ. لكنها تظهر أن السعر والسياق القابل للاستخدام يمكن أن يتباعدا قبل أن يبدأ النموذج في التفكير.
الجمهور: متوسط
الإجابة المباشرة: لا تقدر منتج ذكاء اصطناعي متعدد اللغات بناءً على عدد توكنات الإنجليزية. اختبر التوكنيزر المحدد على نص الإنتاج المتوافق، وقم بقياس الطلب بالكامل، وقيم الجودة بشكل منفصل، وأعد اختبار كلما تغير النموذج أو التوكنيزر.
ما تقيسه ضريبة توكنيزر LLM
تستقبل نماذج اللغة معرفات التوكن، وليس الكلمات أو الأحرف. يقوم التوكنيزر بتقسيم النص إلى وحدات توكن ويقوم بربطها بمعرفات؛ بعض التوكنيزرات تقوم بتطبيع النص أولاً. يمكن أن تناسب الشظايا الشائعة توكن واحد. قد تنكسر النصوص أو أشكال الكلمات الأقل تمثيلًا إلى عدة توكنات أو بايتات.
المقياس الرئيسي في الورقة هو خصوبة الكلمات: توكنات لكل كلمة مفصولة بمسافة. ضريبة التوكنيزر هي خصوبة الكلمات للغة واحدة مقسومة على خصوبة الكلمات الإنجليزية تحت نفس التوكنيزر.
لشاشة الإنتاج، غالبًا ما يكون من الأسهل استخدام نسبة عدد التوكنات المتوافقة:
text نسبة عدد التوكنات المتوافقة للغة L = التوكنات للمحتوى المتوافق باللغة L ÷ التوكنات للإصدار الإنجليزي
تجيب هذه المقاييس على أسئلة ذات صلة، لكنها ليست قابلة للتبادل. سمِّ المقياس الذي تقوم بالإبلاغ عنه. تحتاج كلا المقارنتين إلى نص متوافق دلاليًا. يمكن أن يؤدي عد الجمل غير المرتبطة، أو قائمة من الكلمات الشائعة، إلى إنتاج رقم جذاب يقول القليل عن تطبيق حقيقي.
يستخدم الباحثون أيضًا الخصوبة، التي غالبًا ما تُعرف بأنها توكنات لكل كلمة. خصوبة الكلمات بديهية، لكن حدود الكلمات ليست واضحة بالتساوي عبر اللغات. أضف خصوبة الأحرف، والبايتات لكل توكن، ونسبة البايتات غير المدمجة عندما تحتاج إلى تشخيص سبب وجود فجوة.
تعتبر هذه التمييزات مهمة لأن عدد التوكنات له عدة عواقب مختلفة:
| السؤال | ماذا يخبرك عدد التوكنات | ماذا لا يثبت |
|---|---|---|
| --- | --- | --- |
| كم ستكلف API؟ | مدخل مباشر إلى الفاتورة عندما يقوم المزود بالتسعير لكل توكن | الفاتورة النهائية عندما تنطبق سياسة التخزين المؤقت، أو الدفعات، أو الخصومات |
| كم من النص يناسب؟ | حد مباشر تحت نافذة سياق قائمة على التوكن | كم من السياق سيستخدمه النموذج بشكل جيد |
| هل سيكون الطلب أبطأ؟ | يمكن أن تضيف المزيد من التوكنات عبء معالجة | مضاعف زمن ثابت عبر المزودين والأجهزة |
| هل ستكون الإجابة أسوأ؟ | سبب لإجراء اختبار جودة خاص باللغة | أن التوكنيزر تسبب فجوة في الدقة |
الصف الأخير هو الأسهل في المبالغة فيه.
ما وجدته الأبحاث في 2026
استخدمت دراسة ضريبة التوكنيزر جملًا متوافقة من FLORES-200. قارن بين عشر لغات هندية مع الإنجليزية، العربية، الإسبانية، والفرنسية عبر ستة توكنيزرات. قام المؤلفون بقياس خصوبة الكلمات والأحرف، والبايتات لكل توكن، والتوكنات غير المدمجة ذات البايت الواحد، وكمية النص المصدر الذي نجا من ميزانية سياق ثابتة.
ثلاث نتائج مهمة لقرارات الهندسة:
أنتجت اللغات ذات الضرائب العالية توكنات غير مدمجة ذات بايت واحد بنسبة 27–43% من توكناتها. عبر اللغات الم sampled ذات حدود الكلمات الصالحة، كان هذا المعدل مرتبطًا بضريبة خصوبة الكلمات عند `r = 0.89`. ينسب المؤلفون الفجوة إلى تغطية المفردات غير الكافية لتلك النصوص.
وجدت ورقة NeurIPS 2023 اختلافات في طول التوكنات تصل إلى 15 مرة عبر اللغات. قيست دراسة EMNLP 2023 التكلفة والفائدة عبر 22 لغة ووجدت أن تسعير API القائم على التوكن يمكن أن يكلف بعض مجتمعات اللغات أكثر من المحتوى المماثل.
تظهر الأعمال الحديثة أيضًا أن الفجوة هي خيار تصميم، وليست خاصية لا مفر منها لنص. يغير ترميز بايت-باير المتوافق مع التكافؤ (BPE) الهدف من الدمج لمساعدة اللغة الأقل ضغطًا حاليًا. أفاد مؤلفوه بتقليل عدم المساواة في تكلفة التوكن بنسبة تصل إلى 89%، مقاسة بمعامل جيني عبر اللغات، مع تغيير طفيف في الضغط العالمي. وضعت دراسة مراقبة عبر 11 لغة من جنوب شرق آسيا BPE المتوافق مع التكافؤ على حدود كفاءة–عدالة Pareto لنماذج أساسية تحتوي على 1.5 مليار معلمة. لا يثبت هذا النتيجة نفس التجارة عند نطاق الحدود أو بعد التوافق.
تحتاج ادعاءات الدقة إلى ضبط
وجدت دراسة يوليو ارتباطًا خامًا قدره `r = -0.61` بين الخصوبة ودقة الفهم القرائي لـ 13 نقطة لغوية. بعد التحكم في مستوى موارد اللغة، أصبحت العلاقة الجزئية `r = 0.25`.
هناك أسباب أكثر لتجنب عنوان سببي: جاءت أرقام الخصوبة ودرجات الدقة من إعدادات توكنيزر/نموذج مختلفة، كانت العينة صغيرة، والجمل المرجعية المترجمة ليست عبء عمل إنتاجي. تدعم الورقة ادعاءات قوية حول عدد التوكنات، والسياق، والتكاليف المعتمدة على التوكن. لكنها لا تعزل خصوبة التوكنيزر كسبب لجودة الإجابة المنخفضة.
قياس تكلفة التوكنات متعددة اللغات الخاصة بك
تقدم الأبحاث تحذيرًا، وليس نسبة الإنتاج الخاصة بك. لدى مساعد الدعم، أو نظام الاسترجاع، أو وكيل الترميز مزيج لغوي خاص به وبنية مطالبة.
استخدم هذا التدفق العملي قبل الإطلاق وبعد كل تغيير في النموذج.
1. بناء عينة متوافقة
لشاشة أولية، اجمع 100–1,000 مثالًا من عبء العمل الذي تتوقعه:
استخدم ترجمات مراجعة بنفس المعنى. احتفظ بمعرف يربط كل متغير لغوي. لا تقارن نصوصًا عشوائية مأخوذة من مجموعات لغوية منفصلة. لا تعتبر هذه النطاقات من الحد الأدنى الإحصائي: تعتمد العينة المطلوبة على عدد اللغات، وتباين عبء العمل، ومدى دقة تقدير سلوك الذيل.
قم بتخزين العينة كخطوط JSON:
{"id":"support-001","language":"en","text":"Reviewed English text"} {"id":"support-001","language":"sv","text":"Reviewed Swedish translation"} {"id":"support-001","language":"tr","text":"Reviewed Turkish translation"}
2. تثبيت التوكنيزر
ينتمي التوكنيزر إلى إصدار نموذج. سجل كلاهما. يكشف مستودع `tiktoken` الرسمي عن `cl100k_base` و `o200k_base`؛ كما يظهر تخطيط النموذج أن عائلات النماذج يمكن أن تستخدم ترميزات مختلفة. بالنسبة لنموذج مغلق، يفضل استخدام العداد الرسمي للمزود عندما يكون موجودًا. على سبيل المثال، يكشف API Gemini من Google عن طريقة `countTokens`. بالنسبة لنموذج مفتوح، قم بتحميل الأداة الدقيقة مع خط أنابيب التوكنيزر الموثق للنموذج، مثل ذلك الموضح في Hugging Face Tokenizers API.
لا تفترض أن نموذجين من نفس البائع يشتركان في توكنيزر. لا تفترض أن مكتبة محلية تعرف بالفعل نموذجًا تم إصداره بالأمس.
3. احسب توزيعًا، وليس نسبة واحدة
قم بتثبيت وتثبيت العداد:
bash python -m pip install "tiktoken==0.13.0"
ثم قم بتشغيل:
python import json from collections import defaultdict from math import ceil from statistics import mean, median
import tiktoken
BASELINE = "en" ENCODINGS = ("cl100k_base", "o200k_base")
groups = defaultdict(dict) with open("aligned-samples.jsonl", encoding="utf-8") as source: for line in source: row = json.loads(line) groups[row["id"]][row["language"]] = row["text"]
def percentile(values, probability): ordered = sorted(values) index = max(0, ceil(len(ordered) * probability) - 1) return ordered[index]
for encoding_name in ENCODINGS: encoding = tiktoken.get_encoding(encoding_name) counts = defaultdict(list) ratios = defaultdict(list)
for sample_id, variants in groups.items(): if BASELINE not in variants: raise ValueError(f"{sample_id} has no {BASELINE} baseline")
baseline_tokens = len(encoding.encode(variants[BASELINE])) if baseline_tokens == 0: raise ValueError(f"{sample_id} has an empty baseline")
for language, text in variants.items(): token_count = len(encoding.encode(text)) counts[language].append(token_count) ratios[language].append(token_count / baseline_tokens)
for language in sorted(counts): print( encoding_name, language, f"mean_tokens={mean(counts[language]):.1f}", f"mean_ratio={mean(ratios[language]):.2f}x", f"median_ratio={median(ratios[language]):.2f}x", f"p95_ratio={percentile(ratios[language], 0.95):.2f}x", f"max_ratio={max(ratios[language]):.2f}x", sep="\t", )
يمكن أن يخفي المتوسط بعض الطلبات الطويلة التي تتجاوز نافذة السياق. افحص p50 (الوسيط)، p95 (النسبة المئوية 95)، والحد الأقصى قبل استخدام النتيجة في خطة السعة.
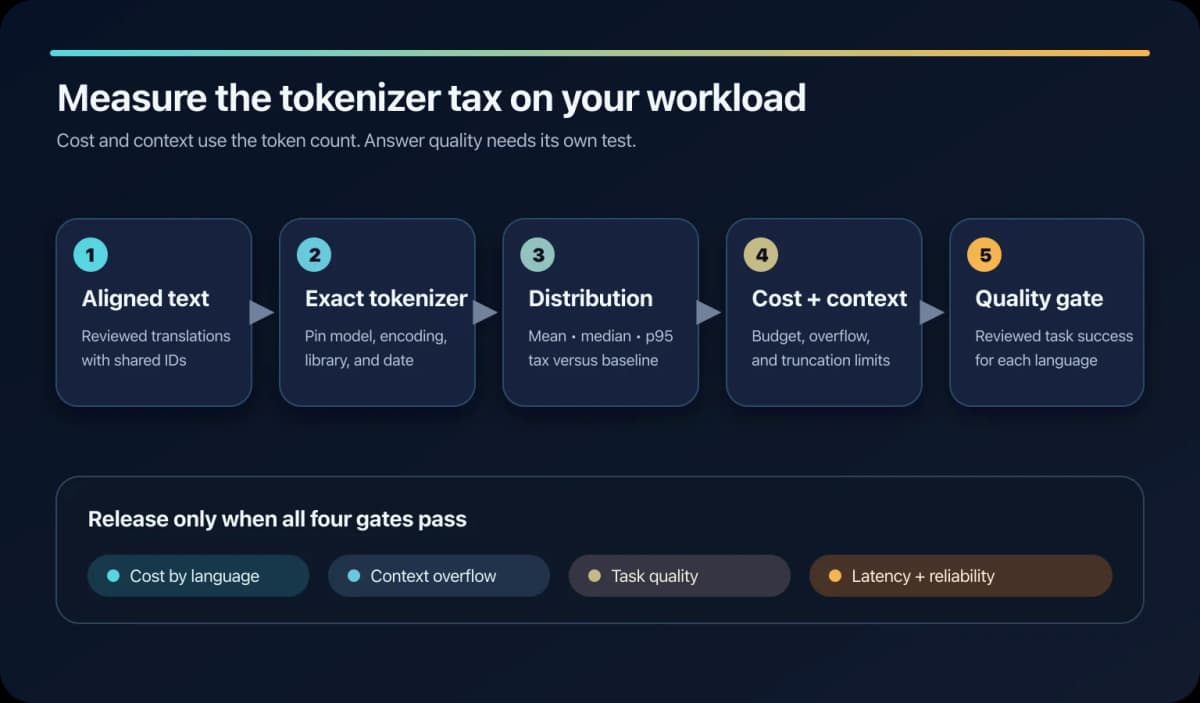
*قم بقياس نص الإنتاج المتوافق مع التوكنيزر المنشور، ثم استخدم التوزيع لتحديد حدود التكلفة والسياق. تظل الجودة تقييمًا منفصلًا.*
4. قياس الطلب الكامل
الرسالة المرئية للمستخدم هي جزء واحد فقط من مكالمة API. تشمل:
هذا مهم بشكل خاص للوكلاء. يمكن أن تهيمن مخطط أداة JSON الكبير على طلب مستخدم قصير. يمكن أن تهيمن مقطع RAG المحلي على مطالبة النظام باللغة الإنجليزية. قم بقياس الطلب النهائي المسلسل كلما كشف المزود عن ذلك التمثيل.
5. تحويل التوكنات إلى حدود تشغيلية
بالنسبة لـ API بسيط يعتمد على التوكن:
text تكلفة الإدخال الشهرية = عدد المكالمات الشهرية × متوسط توكنات الإدخال × السعر لكل مليون توكن ÷ 1,000,000
افترض أن API افتراضية تتقاضى 1 دولار لكل مليون توكن إدخال. تكلف مليون طلب عند 1,000 توكن إدخال 1,000 دولار. إذا كانت الطلبات المتوافقة بلغة أخرى تتوسط 2,500 توكن، فإن جزء الإدخال يصبح 2,500 دولار قبل التخزين المؤقت أو الخصومات.
تحتاج السياق إلى حساب منفصل:
text ميزانية الإدخال القابلة للاستخدام = نافذة السياق
طبق نسبة اللغة الملاحظة على جزء المحتوى، وليس بشكل أعمى على الطلب بالكامل.
توضح دليل تكلفة توكنات التفكير الاصطناعي لماذا تحتاج ميزانيات التوكن إلى حد للمنتج، وليس فقط حد للنموذج. بالنسبة لأنظمة RAG والترميز، توضح تصميم السياق عبر المستودعات لماذا لا يكون إرسال المزيد من السياق مفيدًا تلقائيًا. إذا كانت خيارات API لا تزال مفتوحة، فإن دراسة حالة API للذكاء الاصطناعي المجاني توفر إطار مقارنة أوسع.
تعيين بوابة قبول متعددة اللغات
نسبة توكن أقل مفيدة فقط إذا كان النموذج لا يزال يلبي متطلبات المنتج. استخدم أربع بوابات منفصلة:
| البوابة | مقياس المثال | القرار |
|---|---|---|
| --- | --- | --- |
| التكلفة | تكلفة الإدخال p50 و p95 حسب اللغة | ارفض أو أعد توجيه عندما تتجاوز الميزانية |
| السياق | معدل الفائض والاقتطاع حسب اللغة | غير تجزئة، استرجاع، أو نافذة نموذج |
| الجودة | نجاح المهمة على مجموعة مراجعة لكل لغة | لا تستنتج ذلك من عدد التوكنات |
| العمليات | زمن الاستجابة p50 و p95، معدل الخطأ، معدل نجاح التخزين المؤقت | تحقق على المزود والمنطقة الفعليين |
بالنسبة لنظام RAG متعدد اللغات، قم بتجزئة بواسطة التوكنيزر المنشور بدلاً من عدد الأحرف المشتركة. بالنسبة لوكيل، قم بقياس تتبع الأدوات وإعادة المحاولة بالإضافة إلى الطلب الأول. بالنسبة لمنتج الدعم، تتبع التكلفة لكل حالة تم حلها، وليس التكلفة لكل مكالمة. تمنع هذه الخيارات مقياس التوكن من أن يصبح معيارًا زائفًا.
استخدم مسارًا محددًا للغة فقط عندما يحسن النتيجة الكاملة. يمكن أن يوفر توكنيزر أرخص مقترنًا بنموذج أضعف توكنات الإدخال ويزيد من إعادة المحاولة. يمكن أن يخفي نافذة السياق الأكبر تجزئة سيئة حتى تنمو الفاتورة. الوحدة الصحيحة هي المهمة المكتملة للمستخدم.
ما يمكن أن تغيره الفرق
لا يمكن لفرق التطبيقات إعادة تدريب توكنيزر نموذج تجاري، لكن لا تزال لديهم خيارات:
لدى الفرق التي تدرب نماذجها الخاصة خيار أعمق. تشير نتائج BPE المتوافقة مع التكافؤ إلى أن هدف التوكنيزر يمكن أن يقلل من عدم المساواة عبر اللغات دون التضحية بالكثير من الضغط الكلي. تضيف دراسة جنوب شرق آسيا أدلة مراقبة أن العدالة والكفاءة لا يجب أن تتحرك في اتجاهات متعارضة.
اعتبر التوكنيزر جزءًا من عقد النموذج. قم بإصداره، وقم بعمل تقييم له، وضمنه في مراجعات الهجرة.
حدود الأدلة
الدراسة الأحدث هي مسودة مسبقة. تستخدم جمل FLORES-200 المترجمة، وهي مجموعة متواضعة من اللغات، ومقياس كلمات قائم على المسافة لا يناسب كل نظام كتابة بشكل متساوٍ. طريقة اكتشاف البايت الخاصة بها محددة بالتوكنيزر.
الاستنتاج الأقوى هو مستقل عن النموذج: عندما تنتج لغة واحدة متوافقة المزيد من التوكنات، فإنها تحصل على نص أقل في نافذة توكن ثابتة. يحتفظ استنتاج التكلفة عندما يقوم المزود بفوترة تلك التوكنات الإضافية بنفس سعر الوحدة. يمكن أن تغير سياسات التخزين المؤقت والخصومات الحجم النهائي.
تحتاج الدقة إلى اختبار خاص بها. تؤثر تغطية بيانات التدريب، وهندسة النموذج، وتصميم التقييم بعد التدريب، والسياق الثقافي على النتائج. قد تسهم خصوبة التوكن في فجوة، لكن ورقة يوليو لا تعزل ذلك التأثير السببي.
قائمة مراجعة توكنيزر متعدد اللغات
الأسئلة الشائعة
لماذا تستخدم بعض اللغات المزيد من توكنات LLM؟
تعكس مفردات الكلمات الفرعية بيانات تدريبها وقواعد الدمج. غالبًا ما يتم تمثيل الشظايا الشائعة في الإنجليزية بكفاءة، بينما يمكن تقسيم النصوص الأقل تمثيلًا إلى قطع أصغر أو بايتات. يعتمد حجم الفجوة على التوكنيزر المحدد والنص.
هل يعني عدد التوكنات الأعلى إجابة أسوأ؟
لا. يؤثر ذلك مباشرة على التكلفة المعتمدة على التوكن وكمية النص التي تناسب نافذة التوكن. لا يثبت جودة الإجابة المنخفضة. اختبر الجودة بشكل منفصل على أمثلة مراجعة في كل لغة.
كيف يمكنني عد التوكنات قبل مكالمة API؟
استخدم نقطة العد الرسمية للمزود عند توفرها. بالنسبة لترميزات OpenAI، يمكن لـ `tiktoken` العد محليًا. بالنسبة للنماذج المفتوحة، قم بتحميل الأداة الدقيقة المرسلة مع النموذج. قم بتثبيت الإصدارات حتى لا يغير التحديث اللاحق القياس بصمت.
هل يمكن أن يؤدي تبديل النماذج إلى إزالة ضريبة التوكنيزر؟
يمكن أن يقلل الفجوة. وجدت دراسة يوليو تحسنًا كبيرًا بين `cl100k_base` و `o200k_base`. كما أن تبديل النموذج يغير الجودة، وتكلفة الإخراج، والتخزين المؤقت، والزمن، والسلوك التشغيلي، لذا قارن عبء العمل الكامل بدلاً من عدد التوكنات فقط.
المصادر
فحوصات الادعاءات
| الادعاء | الحالة | حدود الأدلة |
|---|---|---|
| --- | --- | --- |
| بلغ متوسط ضريبة خصوبة الكلمات الهندية 8.0× ووصلت إلى 13.04× للمالايالامية على عينة الدراسة | تم التحقق منه | تم الإبلاغ عنه لـ 997 جملة متوافقة من FLORES-200، وليس كل مطالبة |
| خفضت `o200k_base` متوسط الضريبة في الدراسة إلى 2.1× | تم التحقق منه | مقارنة توكنيزر؛ ليست مقارنة جودة نموذج كاملة |
| احتفظت اللغات ذات الضرائب العالية بـ 12–23% من الأحرف القابلة للاستخدام الإنجليزية عند 8,192 توكن | تم التحقق منه | نتيجة سياقية خالية من النموذج على نص الدراسة المتوافق |
| قلل BPE المتوافق مع التكافؤ من عدم المساواة في تكلفة التوكن عبر اللغات بنسبة تصل إلى 89% | تم التحقق منه | نتيجة قائمة على Gini من المؤلفين تحت إعداد التدريب والتقييم الخاص بهم |
| تسبب ضريبة توكنيزر أعلى في انخفاض دقة الإجابة | لم يتم إثباته | لم تدعم التحليل المعدل في ورقة يوليو قراءة سببية بسيطة |