يجذب GPT-6.1 Sol انتباهي لأنني أريد تشغيل المزيد من مهام الوكلاء المفيدة من دون التعامل مع كل مهمة باعتبارها تكلفة لنموذج متميز. والسؤال المهم هو: ما مقدار العمل الصحيح والقابل للمراجعة الذي يمكنني الحصول عليه ضمن الميزانية؟
انطباعي الأول: يستحق Sol أن يكون ضمن النقاش حول النموذج المستخدم يوميًا. ولا يزال Claude Opus 5.5 يستحق مقارنة جادة، خصوصًا عندما تكون الجودة أهم من سرعة الاستجابة الأولى. سأختبر كليهما على أعمال حقيقية. في الوقت الحالي، أفصل بين المعايير المنشورة وتقارير المستخدمين الأوائل وتوقعاتي الخاصة.
*مراجعة المصدر: 29 سبتمبر 2026. الصورة الرئيسية رسم توضيحي تحريري مولّد بواسطة AI. رسمت مخططات البيانات اعتمادًا على القيم المنشورة المذكورة في المصادر؛ وهي ليست لقطات شاشة من اختباراتي الخاصة.*
ما الاستخدامات المناسبة لـ GPT-6.1 Sol؟
تضع OpenAI نموذج GPT-6.1 Sol في سياق البرمجة المعقدة واستخدام الحاسوب والعمل الاحترافي، مع استهداف مستوى أقرب إلى Astra بسعر أقل. ومعرّف النموذج في API هو gpt-6.1-sol، مع نافذة سياق تبلغ 1,050,000 رمزًا وما يصل إلى 128,000 رمز إخراج. راجع الوثائق الرسمية لنموذج GPT-6.1 Sol.
بالنسبة إلى عملي، يشير ذلك إلى ثلاثة مجالات مفيدة للبدء:
هذه مرشحات للتقييم، وليست وعودًا بأن النموذج سيتعامل معها دون إشراف. وسأبقي عمليات الكتابة في بيئة الإنتاج خلف الموافقة، وسأطلب من الوكيل عرض أدلته.
يتبع ذلك السؤال العملي نفسه الذي طرحته في مراجعتي لـ GPT-6 Astra: هل يساعد النموذج في إتمام العمل عندما يندمج مع نظام قائم؟
تسعير GPT-6.1 Sol مقابل Claude Opus 5.5
المقارنة القياسية في API واضحة ومباشرة. هذه أسعار بالدولار الأمريكي لكل مليون رمز، قبل احتساب الأدوات وعمليات كتابة الذاكرة المؤقتة وعلاوات السرعة أو التعديلات الإقليمية.
| نوع الرموز | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| --- | ---: | ---: |
| الإدخال | $2.00 | $4.00 |
| الإدخال المخزّن مؤقتًا | $0.10 | $0.20 |
| الإخراج | $10.00 | $20.00 |
المصادر: تسعير OpenAI API وتسعير Claude Platform.
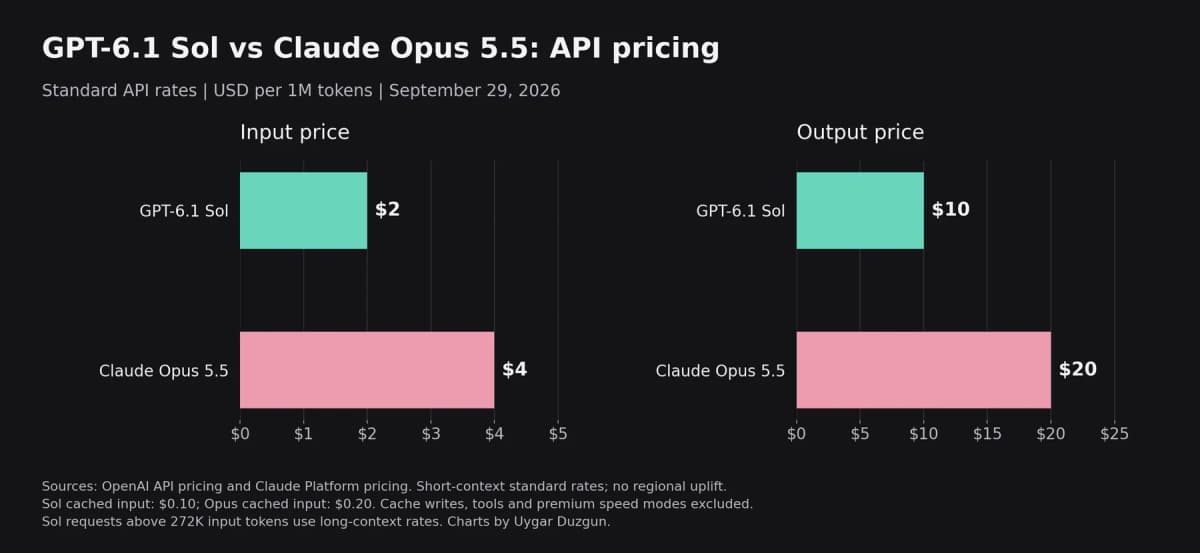
*أسعار السياق القصير القياسية. يتضمن الجدول القراءات المخزّنة مؤقتًا؛ بينما يعرض المخطط أسعار الإدخال والإخراج العادية.*
تبلغ تكلفة Sol نصف تكلفة Opus لكل رمز في هذه الفئات. لكن هذا لا يعني أن تكلفة كل مهمة مكتملة ستكون نصف التكلفة. فقد تستخدم النماذج كميات مختلفة من الاستدلال، وتستدعي أدوات مختلفة، وتحتاج إلى أعداد مختلفة من المحاولات المتكررة.
يغيّر السياق الطويل المقارنة أيضًا. يطبّق Sol أسعارًا أعلى على كامل الطلب الذي يتجاوز 272,000 رمز إدخال في مطالبة واحدة: ضعف سعر الإدخال والإدخال المخزّن مؤقتًا، و1.5 ضعف سعر الإخراج. وتدرج Anthropic التسعير القياسي عبر نافذة السياق الكاملة لـ Opus 5.5. ولا يعادل عدّاد الرموز التراكمي في جلسة طويلة تجاوز مطالبة واحدة لذلك الحد.
للاطلاع على خلفية الإصدار السابق، تغطي نظرتي العامة إلى GPT-6 Sol وLuna التشكيلة السابقة.
معايير GPT-6.1 Sol: النتيجة والتكلفة معًا
AutomationBench: Sol أرخص؛ وOpus يحقق نتيجة أعلى عند الحد الأقصى
يختبر AutomationBench 1.0.6 سير عمل تجارية شاملة عبر 47 أداة. وتقيّم Zapier الحالة الناتجة باستخدام عمليات تحقق حتمية، بدلًا من مطالبة نموذج لغوي آخر بالحكم على الإجابة.
| الإعداد | النتيجة | الدولار الأمريكي لكل مهمة مُحاوَلة |
|---|---|---|
| --- | ---: | ---: |
| Sol 6.1، متوسط | 31.7% | $0.19 |
| Opus 5.5، متوسط، البدائل الاحتياطية الافتراضية | 29.5% | $0.65 |
| Sol 6.1، الحد الأقصى | 36.1% | $0.30 |
| Opus 5.5، الحد الأقصى، البدائل الاحتياطية الافتراضية | 42.5% | $1.44 |
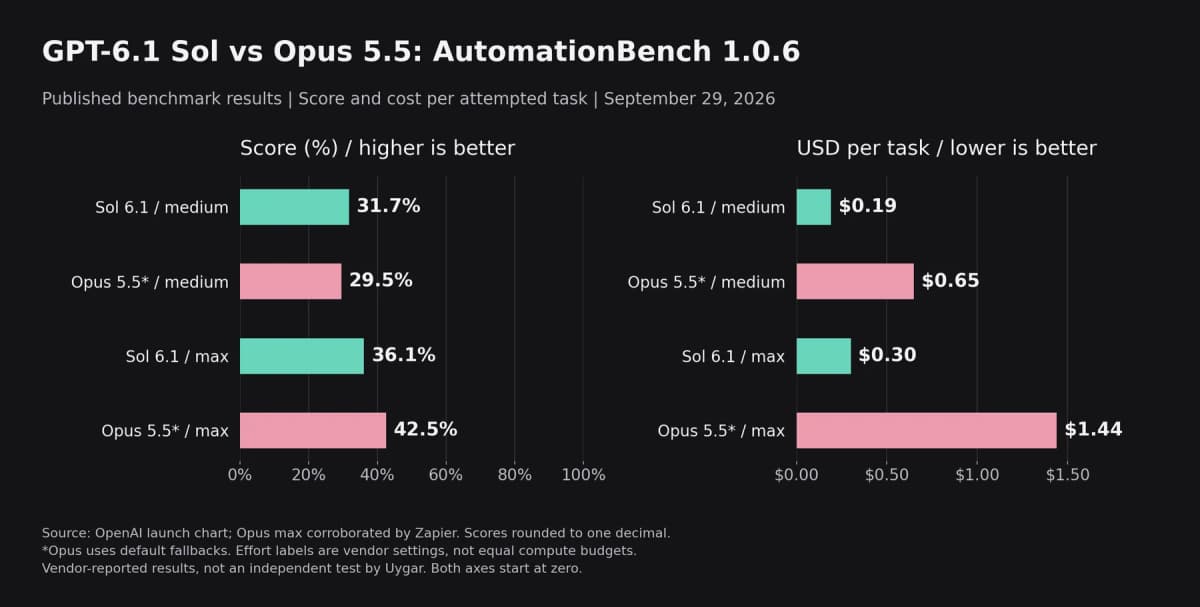
*القيم مأخوذة من مخططات إطلاق OpenAI، مع تقريب النتائج إلى منزلة عشرية واحدة. وتؤكد Zapier نتيجة Opus عند الحد الأقصى. يتضمن إعداد Opus بدائل احتياطية افتراضية؛ ولا تمثل تسميات الجهد لدى المورّدين ميزانيات حوسبة متساوية.*
عند المستوى المتوسط، يقدم Sol تقدمًا متواضعًا في النتيجة وتكلفة مهمة مُعلنة أقل. وعند الحد الأقصى، يحقق Opus النتيجة الأعلى. وسأختار بين هذه المفاضلات باستخدام تكلفة فشل سير العمل، بما في ذلك الوقت الذي يقضيه شخص ما في مراجعته.
تغطي هذه التكاليف المهام المُحاوَلة، بما في ذلك حالات الفشل. وهي ليست أسعارًا لنتيجة تجارية ناجحة مضمونة.
DeepSWE: ترقية مفيدة مقارنةً بـ Sol السابق
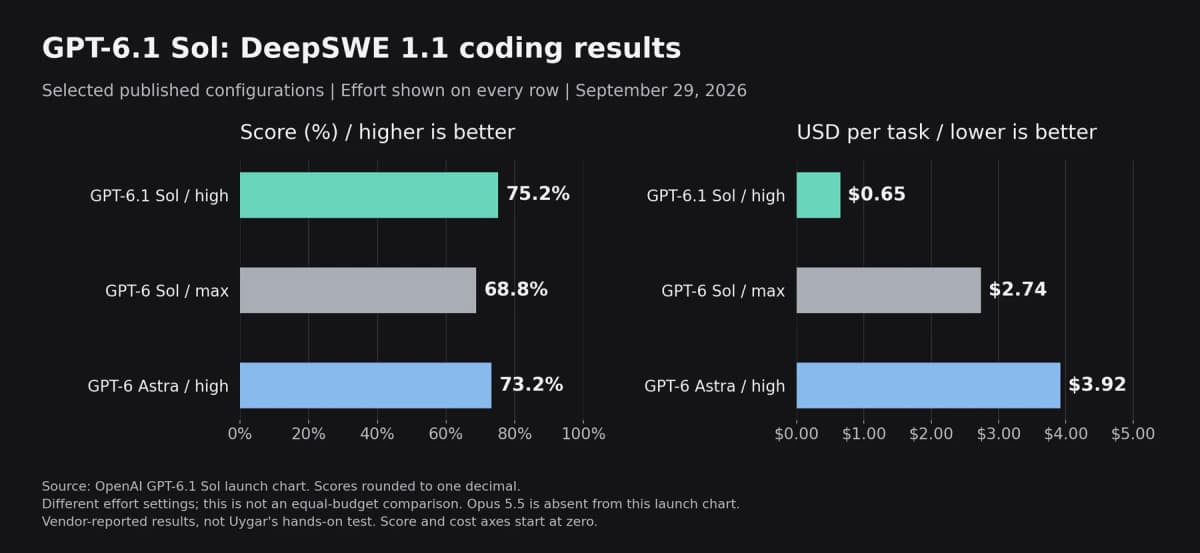
*قيم مختارة من DeepSWE 1.1 من مخططات إطلاق OpenAI نفسها: Sol 6.1 عند الجهد العالي، 75.2% بتكلفة $0.65؛ وSol السابق عند الحد الأقصى، 68.8% بتكلفة $2.74؛ وAstra عند الجهد العالي، 73.2% بتكلفة $3.92 لكل مهمة. إعدادات الجهد المختلفة موضحة صراحةً.*
يستخدم معيار DeepSWE مهام مستودعات طويلة الأفق وعمليات تحقق سلوكية. ولا تتضمن OpenAI نموذج Opus 5.5 في مخطط الإطلاق هذا. ولن أضع نتيجة FrontierCode غير المرتبطة بجانبه وأتظاهر بأنهما يقيسان الشيء نفسه.
تجمع OpenAI بين تقييماتها الخاصة ونتائج المنافسين المُعلنة للعامة. تعامل مع هذا باعتباره دليلًا منشورًا، لا اختبارًا مستقلًا مباشرًا أجريه بنفسي.
أين لا يزال Claude Opus 5.5 مهمًا؟
تضع Anthropic نموذج Opus 5.5 في سياق البرمجة طويلة الأمد والعمل المعرفي. ويمنح تقرير الإطلاق الخاص به نتيجة 54.6% في FrontierCode v1.1 Main عند مستوى الجهد المتوسط الافتراضي، ويصف تحسينات في البرمجة متعددة الملفات. تستخدم هذه النتائج معيارًا مختلفًا عن DeepSWE. كما تتضمن Anthropic ملاحظات مبكرة من شركاء حول تقليل الخطوات والرموز، وهي تظل ملاحظات منسوبة إلى أصحابها وليست مقارنة مضبوطة مع Sol 6.1. راجع إعلان Opus 5.5.
سأبقي Opus ضمن المقارنة للتغييرات الصعبة والمراجعة والعمل المرئي، حيث قد تحسّن جولة أخرى النتيجة النهائية. وسأختبر هذه الفرضية بدلًا من منح النموذج دورًا تخصصيًا دائمًا استنادًا إلى أسبوع الإطلاق.
تغطي معاييري وردود الفعل حول Claude Opus 5.5 إصداره بمزيد من التفصيل.
ماذا يقول المستخدمون الآخرون؟
ردود الفعل المبكرة متباينة. في نقاش حول الإطلاق على Reddit، رحّب بعض المستخدمين بعمليات القراءة المخزّنة مؤقتًا الأرخص؛ بينما شكك آخرون في مدى قرب إحساس النموذج من Astra وفضّلوا Claude. هذه ردود فعل فردية وليست استطلاعًا تمثيليًا.
واستخدم اختبار آخر أكثر تحديدًا لثلاثة نماذج من digitalml مطالبة مشهد Three.js السينمائي نفسها عند مستوى الجهد المتوسط. وكانت الأزمنة المُعلنة 8 دقائق و42 ثانية لـ Sol 6.1، و9 دقائق و37 ثانية لـ Astra، و38 دقيقة و54 ثانية لـ Opus 5.5. فضّل المؤلف النتيجة السينمائية لـ Opus، وأفاد بوجود مشكلات في الكاميرا والصوت في نسخة Sol.
يلتقط هذا المثال الواحد مفاضلة تستحق التحقيق: قد يكون الإنهاء أولًا مهمًا، لكن الصقل والسلوك بعد تحميل الصفحة مهمان أيضًا. ولا يثبت ذلك ترتيبًا عامًا للسرعة أو الجودة.
كيف سأختبر GPT-6.1 Sol
سأعطي Sol وOpus المهمة نفسها وملفات البداية نفسها وإمكانية الوصول إلى الأدوات نفسها وعمليات التحقق من القبول نفسها. أريد تسجيل الصحة والوقت المنقضي والمحاولات المتكررة وتكلفة الرموز وأعمال المراجعة التي لا يزال يتعين عليّ تنفيذها. فالإجابة السريعة التي تتركني أصلح التراجعات ليست نتيجة رخيصة.
بالنسبة إلى تكاملات API، يتطلب Sol استخدام Responses API لاستدعاء الأدوات؛ بينما يدعم Chat Completions ذلك من دون أدوات. وهو يدعم مستويات جهد الاستدلال low وmedium وhigh وxhigh وmax، مع كون medium هو الافتراضي. وتحدد وثائق النموذج المذكورة أعلاه هذه القيود.
نقطة البداية العملية بالنسبة إليّ هي المستوى المتوسط، وموجز محدد النطاق، وعمليات تحقق قابلة للتشغيل. وسأرفع مستوى الجهد عندما تحتاج المهمة إلى ذلك، ثم أقارن النتيجة. ينبغي أن يكسب الاستدلال الإضافي وقته وتكلفته الإضافيين.
أنا متحمس لتجربة GPT-6.1 Sol لأن نسبة السعر إلى الأداء المنشورة تبدو مفيدة لأعمال الوكلاء المتكررة. ولا يزال Opus 5.5 بديلًا قويًا. وسأقرر أين ينتمي كل منهما بعد أن أحصل على أدلة من المهام التي أحتاج إلى إنجازها.
---