لفهم كيفية استخدام الذكاء الاصطناعي للتعلم دون تفويض تفكيرك، اجعل النموذج ينتظر.
حاول المشكلة أولاً، اطلب منه تحديد أول فجوة في تفكيرك، خذ تلميحًا واحدًا في كل مرة، ثم أغلق الدردشة وأعد بناء الإجابة من الذاكرة. أنهي بمشكلة جديدة لم يظهرها الذكاء الاصطناعي.
تساعد ورقتان في يوليو 2026 في تفسير سبب أهمية هذه التسلسل. وجدت تجربة عشوائية درجات اختبار أعلى فورية وبعد أسبوع عندما كان لدى الطلاب الجامعيين وصول إلى الذكاء الاصطناعي التوليدي. وجدت دراسة محاكاة منفصلة أن المعلمين من نماذج اللغة الكبيرة غالبًا ما يتدخلون مبكرًا وكشفوا المزيد من الحل أكثر من المعلمين البشريين. تقيس الدراسات أشياء مختلفة ولا تثبت أي منها أن سير العمل واحد يعمل لكل متعلم. معًا، تدعم حدودًا مفيدة: يمكن أن يحسن الذكاء الاصطناعي عملية التعلم، لكن إكمال المهمة ليس دليلًا على أن المتعلم يمكنه الأداء بشكل مستقل.
مستوى القارئ: متوسط. لا تحتاج إلى خلفية في أبحاث التعليم، لكن المقال يميز بين الأدلة العشوائية، ونتائج المحاكاة، والارتباطات الفرعية، والتفسير العملي.
المحتويات
الإجابة القصيرة: التحكم في متى يتدخل الذكاء الاصطناعي
احتفظ بالمحاولة الأولى والاسترجاع النهائي بدون مساعدة. أعط الذكاء الاصطناعي ثلاث مهام ضيقة في ما بينهما: تشخيص الفجوة الأولى، وكشف المساعدة تدريجيًا، وتوليد مشكلة مختلفة تختبر نفس المهارة.
هذه سياسة تدخل يتحكم فيها المتعلم. أنت تقرر متى يمكن للنموذج الدخول، وكم يمكنه الكشف، وما الأدلة التي ستعتبر تعلمًا. لا يمر الأثر المساعد الصحيح بذلك الاختبار بمفرده.
ما الذي قاسته دراسات يوليو فعليًا
لا تدعم أقوى الأدلة الحديثة أي من التطرفين. لا تظهر أن الذكاء الاصطناعي يضر بالتعلم بشكل حتمي. كما أنها لا تظهر أن الوصول إلى نموذج قادر يضمن الفهم.
| الأدلة | النتيجة الرئيسية | ما تدعمه | ما لا يمكن إثباته |
|---|---|---|---|
| --- | --- | --- | --- |
| تجربة عشوائية للطلاب الجامعيين | رفع الوصول إلى الذكاء الاصطناعي درجات اختبار المعرفة الفورية وبعد أسبوع في الإعداد المبلغ عنه | يمكن أن يدعم الذكاء الاصطناعي التعلم تحت تصميم محكم | تأثير كل سير عمل للذكاء الاصطناعي، أو موضوع، أو متعلم، أو أفق زمني |
| محاكاة INT-BENCH | تدخل المعلمين من نماذج اللغة الكبيرة مبكرًا، وغالبًا، وبمحتوى حل كبير | تحتاج المساعدة إلى توقيت وحدود الكشف | نتائج التعلم البشري من استخدام المنتج العادي |
| دراسة تلميحات الجبر المكونة من 77 شخصًا | اجتاز 70% من التلميحات المولدة المراجعة؛ كانت مكاسب التلميحات البشرية أكبر | تتطلب تلميحات الذكاء الاصطناعي فحوصات جودة | تصنيف للمعلمين الحاليين من الذكاء الاصطناعي |
وجدت تجربة عشوائية مكاسب محتفظ بها
الأدلة التجريبية حول تأثير التعلم للذكاء الاصطناعي التوليدي، المقدمة في 9 يوليو، عشوائية 211 طالبًا جامعيًا إلى حالة مسموح بها للذكاء الاصطناعي أو حالة ممنوعة من الذكاء الاصطناعي. تعلم الطلاب موضوعًا غير مألوف - سلسلة الكتل، أو التقاط الكربون، أو كريسبر - ثم كتبوا مقالًا تحليليًا. أخذوا اختبار معرفة غير مساعد على الفور وعادوا بعد حوالي أسبوع لاختبار آخر ومقال بدون ذكاء اصطناعي أو موارد خارجية.
تم قياسه: رفع الوصول إلى الذكاء الاصطناعي درجات الاختبار الفورية بمقدار 6.7 نقطة مئوية من متوسط 56.3%. هذا يعادل 0.27 انحراف معياري في الورقة. بعد حوالي أسبوع، ظل مجموعة المسموح بها للذكاء الاصطناعي متقدمة بمقدار 5.1 نقطة، أيضًا 0.27 انحراف معياري. من بين 211 طالبًا الذين دخلوا الجلسة الأولى، أكمل 204 الجلستين.
تم قياسه: لم يعني الوصول استخدامًا عالميًا. استخدم ثمانية وستون في المئة من مجموعة العلاج الذكاء الاصطناعي. من بين الطلاب المعالجين، استخدم 57% منه لشرح المفاهيم، و31% لصياغة الردود، و17% لتلخيص القراءات.
صنفت الباحثون سجلات ChatGPT من مستخدمي الذكاء الاصطناعي على أنها تعزيز، أو أتمتة، أو مختلطة، أو أخرى. تم تصنيف تسعة وأربعون في المئة على أنها تعزيز خالص و32% على أنها أتمتة خالصة. حصلت مجموعة الأتمتة على المزيد في أول مقال مساعد بالذكاء الاصطناعي، لكن تلك الميزة في المقال انخفضت إلى ما يقرب من الصفر عندما تمت إزالة الذكاء الاصطناعي. احتفظت مجموعة التعزيز بتقديرات اختبار ومقال إيجابية، على الرغم من أن العديد من تقديرات المجموعات الفرعية كانت غير دقيقة إحصائيًا.
حد مهم: تم عشوائية الطلاب للوصول إلى الذكاء الاصطناعي، وليس لسلوك التعزيز أو الأتمتة. وهذا يجعل تأثير الوصول العام سببيًا ضمن الدراسة. التباين السلوكي بين المجموعات هو ارتباط. لا يمكن أن يثبت أن طلب التفسيرات تسبب في الفرق اللاحق.
احتفظ المختبر أيضًا بوقت التعلم ثابتًا إلى حد كبير. يحذر المؤلفون صراحة من أن الدراسة لا تثبت أن اعتماد الذكاء الاصطناعي على نطاق واسع سيرفع إجمالي التعلم. خارج المختبر، قد يستخدم الطالب الذكاء الاصطناعي لإنهاء مبكرًا ويقضي الوقت المحفوظ في مكان آخر.
وجدت محاكاة أن المعلمين من نماذج اللغة الكبيرة يتدخلون مبكرًا جدًا
المساعدون الذكاء الاصطناعي يتدخلون أكثر من اللازم، المقدمة في 23 يوليو، تقدم INT-BENCH. تحاكي طالبًا من نماذج اللغة الكبيرة يحل 1500 مشكلة في تصحيح الشيفرات، والرياضيات، والألغاز الذهنية بينما يشاهد معلم من نماذج اللغة الكبيرة أثر التفكير ويقرر ما إذا كان سيتدخل.
رأى المعلم القياسي الأثر في زيادات مكونة من 50 حرفًا. رأى المعلم العراف الأثر الكامل، والإجابة، وحكم الصحة قبل أن يقرر ما إذا كان سيتدخل ومتى.
تم قياسه: تدخل المعلمون من نماذج اللغة الكبيرة القياسية في 90% من التجارب، في المتوسط بعد 18% من أثر التفكير. مع المعلومات الكاملة، انخفضت وتيرة التدخل إلى 54% وانتقل التوقيت المتوسط إلى 56% من الأثر. أنتجت التدخلات القياسية مكسبًا صافيًا في الدقة بمقدار 0.20: 25.5% من الإجابات الخاطئة في البداية أصبحت صحيحة، بينما 5.4% من الإجابات الصحيحة في البداية أصبحت خاطئة.
تحسنت الدقة الفورية، لكن السياق من المشكلة السابقة والتدخل لم يحسن الأداء بشكل كبير على مشكلة جديدة ذات صلة. تراوحت التغييرات المبلغ عنها في التعميم من -0.04 إلى +0.04 عبر المجالات الثلاثة.
قارن الورقة أيضًا تدخلات نماذج اللغة الكبيرة مع 50 شخصًا يعملون كمعلمين على 30 لغز ذهني. في الحالة القياسية، كشف المعلمون من نماذج اللغة الكبيرة عن الحل الكامل في 14.2% من التدخلات، مقارنة بـ 5.4% للبشر. ظهرت هياكل شبه كاملة في حوالي 45% من تدخلات نماذج اللغة الكبيرة و30% من تدخلات البشر.
حد مهم: درست INT-BENCH الطلاب المحاكيين. لا يعيد نموذج يستمر في أثر التفكير إنتاج الذاكرة البشرية، أو الدافع، أو الارتباك، أو الحمل المعرفي. استخدم اختبار النقل الخاص به مشكلة ذات صلة واحدة على الفور بعد الحلقة الأصلية. لا تقيس الورقة احتفاظ البشر بالمعلومات على مدى أيام أو أشهر.
التفسير العملي: يمكن أن يحسن النموذج الإجابة بينما يستهلك فرصة التفكير. يتطلب التعلم اختبارًا منفصلًا حيث تكون المساعدة غائبة.
لماذا يمكن أن يخفي الناتج الصحيح تعلمًا ضعيفًا
يمكن أن تستجيب الذكاء الاصطناعي لتحسين الأثر أمامك: المعادلة المحلولة، أو الوظيفة الناجحة، أو الفقرة المصقولة، أو الملخص الموجز. هدفك التعليمي مختلف. تحتاج إلى إعادة بناء التفكير لاحقًا وتطبيقه عندما تتغير التفاصيل السطحية.
هذا يخلق ثلاث نتائج متميزة:
| النتيجة | ما تثبته | ما لا تثبته |
|---|---|---|
| --- | --- | --- |
| المهمة المساعدة صحيحة | أنتجت العملية المشتركة بين الإنسان والذكاء الاصطناعي نتيجة صحيحة | يمكن للمتعلم إعادة إنتاج الطريقة |
| يمكن للمتعلم شرح النتيجة | يمكن للمتعلم وصف التفكير الآن | يمكن للمتعلم نقلها إلى حالة جديدة |
| يحل المتعلم حالة جديدة لاحقًا | نجت المهارة من تغيير السياق والوقت | ستظل المهارة بدون ممارسة إضافية |
تشبه الحدود أي سير عمل إنتاجي مدعوم بالذكاء الاصطناعي. يمكن للنظام إنتاج نص يبدو مكتملًا بينما يفقد حكم المؤلف. نفس الخطر مرئي في استخدام الذكاء الاصطناعي دون فقدان سياق ومعايير المؤلف. في الشيفرة، لا يزال يحتاج التصحيح المكتمل إلى اختبار مستقل؛ لا تزيل أحمال وكيل الشيفرة الكبيرة الحاجة إلى التحقق.
يتطلب التعلم طبقة تحقق خاصة به. يجب أن يساعد النموذج في إنشاء الممارسة، وتشخيص الأخطاء، وضبط الصعوبة. يجب ألا يكون المكان الوحيد الذي توجد فيه الإجابة.
كيفية استخدام الذكاء الاصطناعي للتعلم: سير عمل من خمس خطوات
هذا التسلسل هو تجميع عملي، وليس نظرية تعلم جديدة. ينظم إطار TACO في أبريل 2026 التحكم في المتعلم كفكر، واسأل، وتحقق، وامتلك. تم اشتقاقه من تحليل نوعي لتأملات مكتوبة لـ 133 طالبًا في المدارس الثانوية في هونغ كونغ. تضيف الخطوات الخمس أدناه سلم تلميحات صريح، ومشكلة نقل غير مساعدة، وفحص استرجاع مؤجل إلى نفس الحدود التي تركز على الإنسان.
استخدم سير العمل لمفهوم، أو مجموعة مشاكل، أو قطعة شيفرة، أو حجة. يمكن أن تستغرق دورة واحدة 15 دقيقة. قد يحتاج موضوع أصعب إلى عدة دورات.
1. حدد المهارة وحاولها بدون مساعدة
اكتب هدفًا واحدًا قابلًا للملاحظة:
ثم حاول المهمة قبل فتح محادثة الذكاء الاصطناعي. احتفظ بالمحاولة، بما في ذلك النقطة التي أصبحت فيها غير متأكد. هذا يعطي المعلم دليلًا حول فجوتك الفعلية ويمنع إجابة النموذج من أن تصبح فكرتك الأولية.
لا تسأل، "علمني حساب التفاضل والتكامل." اسأل، "يمكنني تفريق كثيرات الحدود، لكن لا أفهم لماذا تضرب قاعدة السلسلة المشتقات. حاولت هذا الشرح وعلقت هنا."
2. اطلب تلميحًا واحدًا، وليس حلاً
حدد ميزانية التدخل. ابدأ بسؤال واحد، أو مثال مضاد، أو تلميح توجيهي. اطلب من النموذج الانتظار لمحاولة أخرى قبل تقديم المزيد.
مستويات التلميح المفيدة:
انتقل إلى الأسفل في القائمة فقط عندما تفشل المستوى السابق. تظل الحل الكامل متاحة، لكنها تصبح التدخل الأخير بدلاً من الافتراضي.
تظهر الدراسة القديمة اختلافات مكاسب التعلم بين تلميحات الجبر التي أنشأها ChatGPT والمعلم البشري لماذا لا تزال التلميحات بحاجة إلى تدقيق. اجتاز 70% من التلميحات التي أنشأها ChatGPT فحوصات الجودة اليدوية في تجربته المكونة من 77 شخصًا. كانت كلا الحالتين لهما مكاسب تعلم إيجابية، لكن المكاسب كانت ذات دلالة إحصائية فقط لتلميحات المؤلف البشري وكانت أكبر من حالة ChatGPT. استخدمت الورقة نظام ChatGPT مبكرًا، لذا لا يمكنها تصنيف النماذج الحالية. لكنها تظهر أن "التلميح" ليس ضمانًا للجودة.
3. اشرح الفكرة مرة أخرى بدون نسخ
اغلق أو اخفِ استجابة النموذج. اشرح الطريقة بكلماتك الخاصة. تشمل:
اطلب من النموذج تقييم الشرح مقابل معيار قصير، وليس لإعادة كتابته على الفور. اطلب أصغر تصحيح مطلوب. إذا ادعى النموذج وجود خطأ واقعي، تحقق من المادة المصدرية قبل قبول التصحيح.
تكون الشروحات الواضحة مفيدة عندما تحافظ على الجوهر الفني. توضح المقالة القصيرة حول تفسيرات الذكاء الاصطناعي التي تجعل الأفكار الصعبة أسهل في المتابعة نفس النقطة: يجب ألا تتطلب إمكانية الوصول التظاهر بأن الموضوع بسيط.
4. حل مشكلة نقل بدون ذكاء اصطناعي
اطلب من النموذج إنشاء مشكلة جديدة تستخدم نفس المهارة الأساسية ولكن تغير الشكل السطحي. أخبره بعدم تضمين الإجابة بعد.
أمثلة:
ثم اغادر الدردشة وحل المشكلة الجديدة بدون مساعدة. قارن نتيجتك فقط بعد الالتزام بإجابة.
تفصل هذه الخطوة نسخ الأنماط عن النقل. كما أنها تستجيب مباشرة لنتيجة INT-BENCH: لم تحسن المساعدة في المشكلة الأصلية أداء الطالب المحاكي بشكل موثوق في مشكلة ذات صلة.
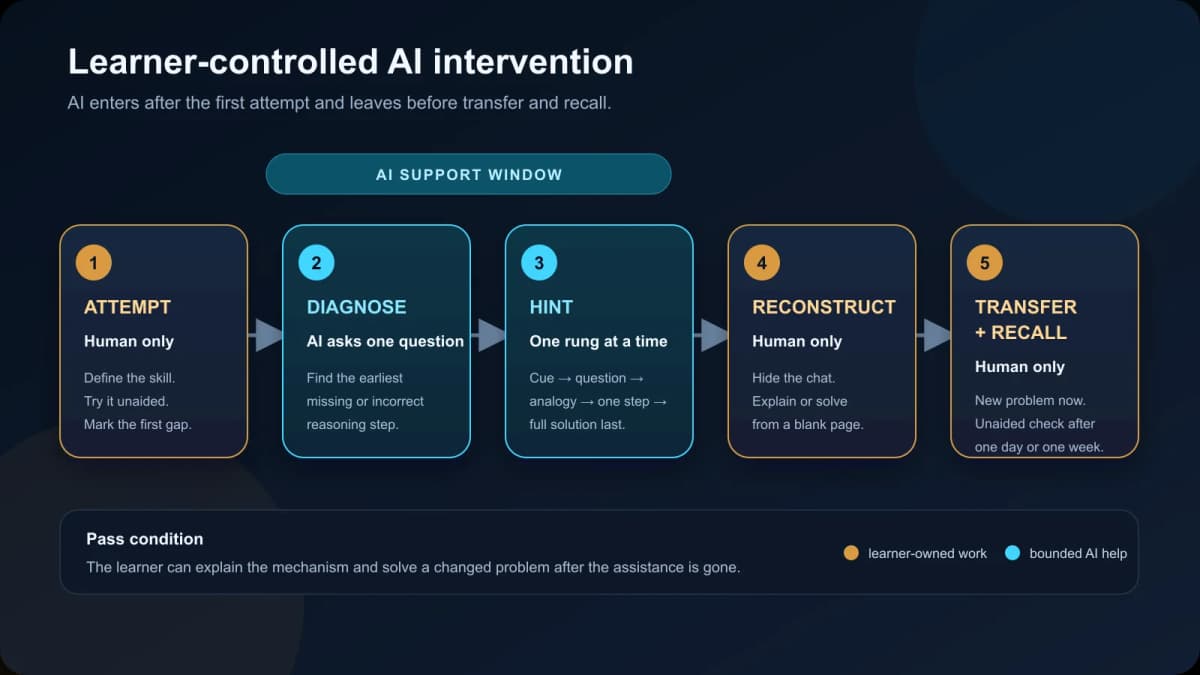
*التعليق: يدخل الذكاء الاصطناعي بعد المحاولة الأولى ويغادر قبل فحوصات النقل والاسترجاع.*
5. قم بتشغيل الاسترجاع المؤجل
انهِ الجلسة بكتابة تلميحين لنفسك في المستقبل:
أجب عنهما في اليوم التالي. بالنسبة للمواد المهمة، كرر بعد أسبوع. لا تعيد فتح محادثة الذكاء الاصطناعي الأصلية حتى تنتهي من محاولة الاسترجاع.
قاس التجربة العشوائية في يوليو الاحتفاظ بعد حوالي أسبوع، لكن هذا سير العمل لا يرث حجم تأثير الورقة. الاسترجاع المؤجل هو الاختبار المحلي: يخبرك ما إذا كان فهمك قد نجا من استخدامك الخاص للذكاء الاصطناعي.
تلميح معلم الذكاء الاصطناعي القابل لإعادة الاستخدام
يعمل هذا التلميح في محادثة عادية أو وضع دراسة منتج. استبدل الحقول المربعة.
text تصرف كمعلم لـ [الموضوع] على [مستواي].
مهارتي المستهدفة: [نتيجة واحدة قابلة للملاحظة]
ما أعرفه بالفعل: [وصف قصير]
محاولتي الأولى: [الصق المحاولة، بما في ذلك المكان الذي علقت فيه]
قواعد هذه الجلسة:
استخدم مادتي المصدر عند تقديمها. ضع علامة على عدم اليقين، ولا تخترع اقتباسًا أو حقيقة عندما لا تدعمها المادة.
قد يكشف نموذج عن الكثير. كرر الحدود في الدور التالي: "أعط فقط أصغر تلميح يساعدني على اتخاذ خطوة أخرى."
كيفية قياس ما إذا كنت قد تعلمت
لا تقيم الجلسة بناءً على مدى تلميع شرح النموذج. سجل الأدلة التي تخص المتعلم.
| الفحص | شرط النجاح |
|---|---|
| --- | --- |
| المحاولة الأولى | توجد محاولة حقيقية قبل المساعدة |
| ميزانية التلميح | لم يكن الحل الكامل هو التدخل الأول |
| شرح العودة | ذكرت الآلية بدون نسخ |
| تشخيص الخطأ | يمكنك تسمية سبب فشل المحاولة الأصلية |
| النقل | حليت مشكلة متغيرة بدون ذكاء اصطناعي |
| الاسترجاع المؤجل | أعادت بناء الفكرة بعد يوم أو أسبوع |
| فحص المصدر | تتطابق الحقائق المهمة مع المادة الدراسية أو المصدر الأساسي |
استخدم سجلًا مضغوطًا:
text المهارة: فجوة المحاولة الأولى: التلميحات المستخدمة: خطأ شرح العودة: نتيجة النقل: استرجاع اليوم التالي: تم فحص المصدر: الممارسة التالية:
لا تعني فشل فحص واحد التخلي عن الذكاء الاصطناعي. إنه يحدد هدف الممارسة التالي. تعني مشكلة النقل الفاشلة العودة إلى الآلية، وليس طلب خمسة أمثلة أخرى مع حلول مرفقة.
ما الذي تغيره وضع الدراسة والتعلم الموجه
يمكن أن تقلل المنتجات الحالية من عبء التوجيه، لكنها لا تزيل الحاجة إلى سير العمل.
وثائق وضع الدراسة من OpenAI، تم التحقق منها في 28 يوليو، تقول إن الوضع يمكن أن يطرح أسئلة، ويشرح المفاهيم في طبقات، ويختبر المتعلم، ويستخدم المواد المحملة، ويوجه بأسلوب سقراطي. تحذر نفس الصفحة من أن وضع الدراسة يمكن أن يرتكب أخطاء وقد يعطي أحيانًا إجابة مباشرة.
وثائق التعلم الموجه من Google، تم التحقق منها أيضًا في 28 يوليو، تصف التعلم الموجه، والوسائل البصرية، والملفات المحملة، والأسئلة التدريبية، والتعليقات، والتلميحات، وموارد OpenStax الاختيارية حيثما كانت متاحة.
صفحة التعليم من Anthropic تقول إن وضع التعلم من Claude يطرح أسئلة تهدف إلى مساعدة الطلاب في العثور على الإجابات. هذه وصفة منتج، وليست نتيجة تعلم مستقلة.
تتحرك المشاريع مفتوحة المصدر في نفس الاتجاه. أطلق مستودع DeepTutor ثمانية إصدارات بين 29 يونيو و26 يوليو. أظهرت تاريخه العام 146 التزامًا و657 فرعًا جديدًا تم إنشاؤه من 28 يونيو حتى تحقق 28 يوليو. تقيس تلك الأرقام النشاط الهندسي، وليس نتائج التعلم، أو اعتماد الفصول الدراسية، أو السلامة.
اختر وضعًا للراحة، ودعم الملفات، وقواعد الخصوصية، والوصول. احتفظ بنفس العقد السلوكي:
أين يمكن أن يفشل هذا سير العمل
يمكن أن يعلم النموذج الشيء الخطأ
يمكن أن تحتوي الشرح الفصيح على فرضية خاطئة، أو اقتباس مخترع، أو خطوة غير صالحة. تحقق من الادعاءات ذات المخاطر العالية والمحددة للدورة ضد المواد المعينة، أو الوثائق الرسمية، أو المصادر الأساسية.
يمكن أن يكشف تلميح عن الإجابة
"فكر في الحفاظ على الطاقة" قد يكون اتجاهًا مفيدًا. فقرة تسمي المعادلة، وتستبدل القيم، وتترك خطوة حسابية واحدة هي حل مع تغيير التسمية. شدد ميزانية التلميح.
يمكنك الخلط بين التعرف والاسترجاع
قراءة الشرح مرتين تخلق ألفة. لا تثبت إعادة البناء. أغلق الإجابة واكتب الآلية من الذاكرة.
يمكن أن تكون مشكلة النقل مشابهة جدًا
تغيير الأرقام فقط يختبر التكرار. اطلب من النموذج تغيير السياق، والتمثيل، والمشتتات مع الحفاظ على المهارة.
يمكن أن يتعارض سير العمل مع قواعد الدورة
اتبع سياسة الذكاء الاصطناعي للمدرس. يمكن أن تكون طريقة الدراسة الفعالة محظورة للعمل المقيَّم، أو المواد المحمية، أو التقييمات.
تظل الأدلة ضيقة
تغطي الورقة العشوائية عينة طلابية انتقائية واحدة، وثلاثة مواضيع تقنية، ومختبر بوقت ثابت، وحوالي أسبوع من الاحتفاظ. تستخدم INT-BENCH طلابًا محاكيين ونقلًا فوريًا. استخدمت دراسة تلميحات الجبر نموذجًا قديمًا و77 مشاركًا. لا يوفر أي منها حجم تأثير عالمي لـ "التدريس بالذكاء الاصطناعي."
الاستنتاج الآمن أضيق: يمكن أن يدعم الذكاء الاصطناعي التعلم، خاصة عندما يساعد المتعلم في فحص وممارسة تفكيره الخاص. يجب أن يقرر النقل المستقل والاسترجاع المؤجل ما إذا كانت الجلسة قد نجحت.
فحوصات الادعاء
| الادعاء | صياغة قائمة على الأدلة |
|---|---|
| --- | --- |
| "يحسن الذكاء الاصطناعي التعلم بمقدار 0.27 انحراف معياري." | أفادت تجربة عشوائية واحدة للطلاب الجامعيين بتأثير اختبار فوري بمقدار 0.27-SD وتأثير بمقدار 0.27-SD بعد حوالي أسبوع تحت تصميمها. |
| "تم إثبات أن التعزيز أفضل من الأتمتة." | عشوائية الدراسة للوصول إلى الذكاء الاصطناعي، وليس نمط الاستخدام. الاختلافات بين مجموعات التعزيز والأتمتة هي ارتباطية وجزئيًا غير دقيقة. |
| "يتدخل المعلمون من الذكاء الاصطناعي مبكرًا جدًا." | فعل أربعة معلمين من نماذج اللغة الكبيرة ذلك في INT-BENCH مع طالب محاكي؛ النتيجة ليست قياسًا عالميًا لكل معلم أو متعلم. |
| "لا تعمل تلميحات الذكاء الاصطناعي." | واسع جدًا. وجدت دراسة الجبر القديمة مكاسب إيجابية في كلا الحالتين، لكن كانت المكاسب البشرية فقط ذات دلالة وكانت 70% من التلميحات المولدة قد اجتازت المراجعة. |
| "هذا سير العمل المكون من خمس خطوات هو بيداغوجيا جديدة." | إنه تجميع عملي يوسع إطار TACO مع سلم تلميحات، ومشكلة نقل، وفحص استرجاع مؤجل. |
| "تحل أوضاع الدراسة المشكلة." | تصف وثائق البائع ميزات الأسئلة، والتلميحات، والاختبارات. كما تعترف بالأخطاء وتسرب الإجابات المباشرة. |
| "تثبت الإجابة المساعدة الصحيحة التعلم." | تثبت نجاح المهمة للعملية المشتركة. يتطلب النقل والاسترجاع المؤجل فحوصات غير مساعدة منفصلة. |