يثير Claude Fable 5.2 اهتمامي لأنني أستخدم Fable بالفعل في أعمال يصعب تقسيمها إلى أسئلة صغيرة ومعزولة. أستخدمه لبناء خطط معقدة، وتبادل الأفكار، والبحث في مشكلة ما، والعمل عبر قواعد الشيفرة حيث تلامس ميزة واحدة عدة أجزاء من النظام.
نادراً ما تكون الدالة الصغيرة هي الجزء الصعب. الجزء الصعب هو فهم ما الذي يجب تغييره أيضاً، وما الذي يجب أن يستمر في العمل.
أطلقت Anthropic إصدار Fable 5.2 في 9 نوفمبر 2026. تبدو النتائج المبكرة واعدة لهذا النوع من العمل. كما توضح سبب عدم إسنادي كل مهمة إليه بأقصى مستوى من الجهد. هذا تحليل للإطلاق مبني على سير عمل Fable الذي أستخدمه حالياً، وليس ادعاءً بأنني أجريت اختبارات معيارية مستقلة على 5.2.
تم التحقق من البحث في 10 نوفمبر 2026. الصورة الرئيسية رسم توضيحي تحريري مولد بواسطة AI، وليست واجهة Anthropic. تستخدم المخططات أدناه بيانات تقييم مسجلة، وليست أرقاماً مولدة.
ما الجديد في Claude Fable 5.2؟
Fable 5.2 هو النموذج الجديد من Anthropic للاستدلال المتطلب والعمل التقني طويل الأمد. تذكر مواصفاته نافذة سياق تبلغ مليون token، وما يصل إلى 128,000 token للإخراج، ودعم إدخال النصوص والصور مع إخراج نصي. تعني نافذة السياق الكبيرة أنه يستطيع استقبال مواد كثيرة؛ لكنها لا تضمن استخدامه كل التفاصيل بشكل صحيح. مواصفات Claude Fable 5.2
تقول Anthropic إن توليد الإخراج أسرع بنسبة تصل إلى 30% مقارنةً بـ Fable 5.1. وهذا ادعاء يتعلق بتوليد tokens، وليس وعداً بأن المشروع بأكمله سينتهي أسرع بنسبة 30%.
يشترك Fable وMythos 5.2 في النموذج الأساسي نفسه، لكنهما يختلفان في وسائل الحماية وإمكانية الوصول. Mythos مخصص للمؤسسات التي تم التحقق منها في مجالات مثل الأمن السيبراني وعلوم الحياة. ولا ينبغي تقديم نتيجة متاحة لـ Mythos فقط على أنها شيء يمكن لكل مستخدم لـ Fable إعادة إنتاجه. Anthropic: إطلاق Fable 5.2 وMythos 5.2
لماذا أستخدم Fable عندما تمتد الميزة عبر قاعدة الشيفرة
تخيل إضافة خطوة موافقة إلى سير عمل رفع مستند. من السهل وصف الزر. لكن التنفيذ الموثوق يحتاج إلى مزيد من التفكير.
يجب على API التحقق من هوية الشخص المخول بالموافقة. ويجب أن تخزن قاعدة البيانات القرار. كما يجب على مهمة تعمل في الخلفية تجنب إرسال الإشعار نفسه مرتين. وتحتاج الواجهة إلى حالات معلقة ومعتمدة وفاشلة. ويجب أن تغطي الاختبارات حالتين يتصرف فيهما شخصان في الوقت نفسه.
أريد أن يفهم النموذج هذه الروابط قبل أن يبدأ التعديل. فقد يؤدي إصلاح كل ملف على حدة إلى ميزة تعمل في شاشة واحدة لكنها تفشل في أماكن أخرى.
التخطيط وتحدي فكرة ما
هنا أحب استخدام Fable كشريك للنقاش. يمكنني وصف النتيجة، واستكشاف أساليب مختلفة، وطلب تحدي الافتراضات منه. أريد خطة تحدد التبعيات وحالات الفشل، بدلاً من قائمة مهام طويلة تبدو منظمة.
على سبيل المثال، ينبغي للنموذج أن يشرح ما إذا كانت الموافقة تنتمي إلى سير العمل الحالي أو تحتاج إلى خدمة منفصلة. كما ينبغي أن يكون قادراً على إخباري بأن التغيير الأصغر كافٍ.
بحث يوجه التنفيذ
يكون البحث مفيداً عندما يغير قراراً ما. أريد من النموذج مقارنة الوثائق، وشرح المفاضلات، والفصل بين القيد المؤكد والتخمين.
المعيار الذي يهمني عملي: هل يمكنني تتبع المصدر، والتحقق من الادعاء، وفهم ما لا يزال غير مؤكد؟ لا تكفي خلاصة واثقة من دون هذه الأدلة، بغض النظر عن النموذج.
ماذا توضح معايير البرمجة؟
يذكر جدول الإطلاق من Anthropic نتيجة 49.1% على FrontierCode 2.0، مقابل 32.4% لـ Fable 5.1 و45.5% لـ Opus 5.5. تستخدم نتيجتا Fable إعداد xhigh للجهد؛ بينما يستخدم Opus إعداد max. هذه أفضل نتائج مختارة بأقصى جهد، وليست مقارنة متساوية التكلفة.
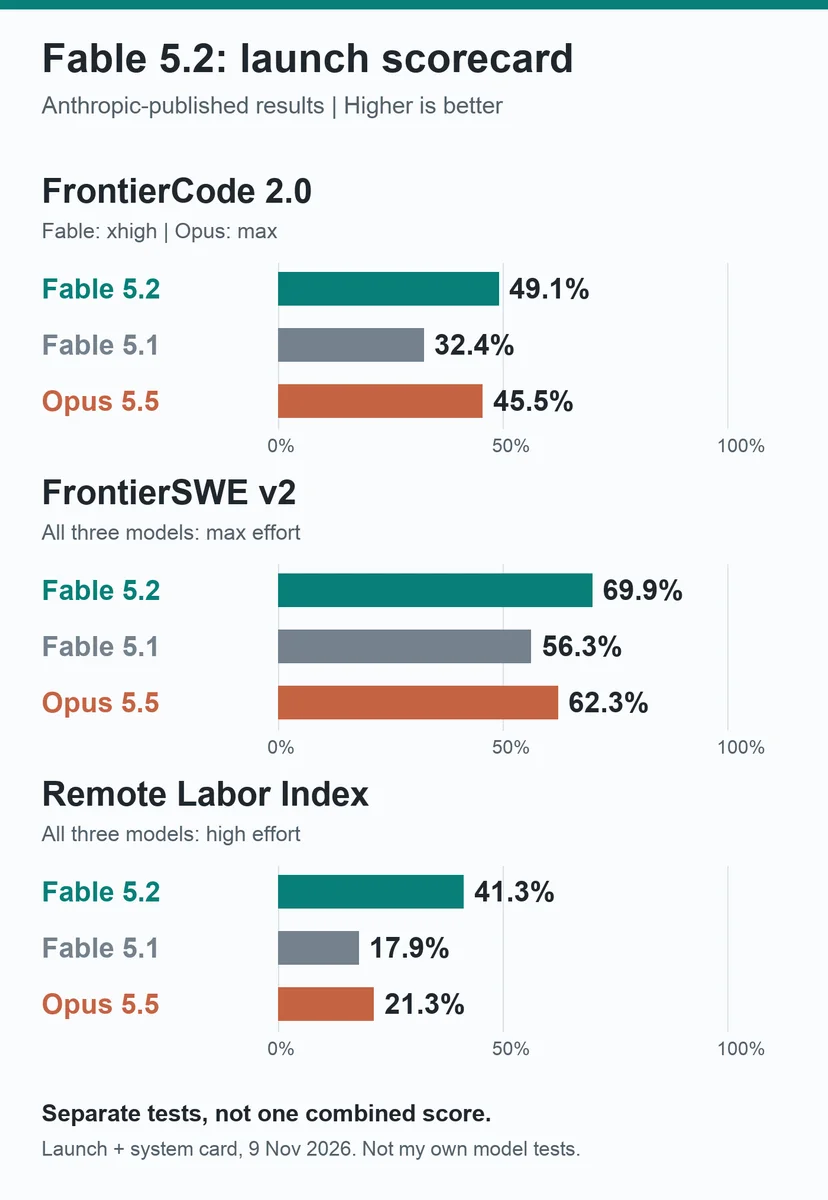
يقيس كل قسم مهمة مختلفة. لا تحسب متوسط النسب. يستخدم FrontierSWE v2 أقصى جهد؛ بينما تستخدم عمليات Claude في Remote Labor Index جهداً عالياً، وسياقاً من 200,000 token، وحداً أقصى للاستجابة يبلغ 32,000 token، وفقاً لبطاقة النظام. بطاقة نظام Anthropic، قسم القدرات
يهمني FrontierSWE بشكل خاص. يصف مؤلفوه 34 مهمة هندسية وبحثية طويلة، مع ميزانية قدرها 20 ساعة لكل مهمة. وهذا أقرب إلى حل المشكلات المستمر من إكمال دالة قصيرة واحدة. لكنه يظل بيئة اختبار محددة، وليس توقعاً لما سيحدث في مستودعاتي. منهجية FrontierSWE v2
كما يسهل المبالغة في تفسير نتيجة Remote Labor Index. لا تعني نتيجة 41.3% في تلك المشروعات أن Fable يستطيع استبدال 41.3% من الوظائف. إنها نتيجة على مجموعة محددة من المخرجات.
ماذا يجد المختبرون المستقلون؟
تشير الاختبارات العامة الأولى إلى قدرات قوية مع حدود مهمة. لكنها لا ترقى بعد إلى إجماع واسع حول قواعد الشيفرة المستخدمة في الإنتاج.
تدرج Artificial Analysis يضع Fable 5.2 عند درجة Intelligence Index مقربة تبلغ 65 مع أقصى جهد في اللقطة التي تحققت منها. وتبلغ نتيجته مع الجهد العالي 62. ويظهر المخطط التالي أن فرق التكلفة كبير. هذه مجموعة تقييم منفصلة عن جدول إطلاق Anthropic. Artificial Analysis: نتائج النموذج
أجرت Spring Prompt اختبارات أعمالها الخاصة في 10 نوفمبر. تصدر Fable اختبارات تحليل الاستبيانات وميزانية الإعلانات المحاكاة، لكن GPT-6.1 Sol كان أكثر موثوقية بقليل في قوائم المنتجات الواقعية وأرخص بكثير لكل قائمة. أُجريت معظم هذه الاختبارات مرة واحدة؛ بينما استخدمت اختبارات قوائم المنتجات ثلاث عمليات تكرار. ويقول الفريق صراحة إنه لم يختبر وكلاء البرمجة معيارياً. أقرأ هذا باعتباره سبباً مبكراً لاختبار الأعمال التي تعتمد على التحليل، وليس دليلاً على تفوقه في عمليات ترحيل البرمجيات. Spring Prompt: مراجعة Fable 5.2 وحدود الاختبارات
وجد Simon Willison تحذيراً مفيداً في تجربة صغيرة لتوليد SVG. أنتج إعداد Xhigh نتيجة، بينما أمضى max حدّه البالغ 128,000 token في التفكير وأعاد النتيجة من دون صورة. هذه تجربة واحدة تم الإبلاغ عنها، وليست معدل فشل عاماً. لكنها كافية لتحدي افتراض أن الإعداد الأعلى ينتج دائماً أفضل إجابة. Simon Willison: التجارب الأولى مع Fable 5.2
كم تبلغ التكلفة، وما مستوى الجهد المناسب؟
تبلغ أسعار API القياسية 8 دولارات لكل مليون token للإدخال و40 دولاراً لكل مليون token للإخراج. وهذا أقل بنسبة 20% من سعر Fable 5.1 البالغ 10/50 دولاراً. وتبلغ تكلفة Opus 5.5 مقدار 4/20 دولاراً. أما قراءات الذاكرة المؤقتة لـ Fable 5.2 فتبلغ 0.20 دولار لكل مليون token؛ بينما تُفرض رسوم منفصلة على عمليات الكتابة في الذاكرة المؤقتة. هذه أسعار API، وليست حصص اشتراك. أسعار Anthropic
تبلغ تكلفة الوضع السريع الاختياري 16/80 دولاراً لكل مليون token للإدخال/الإخراج. وتدعي Anthropic أن توليد tokens يكون أسرع بما يصل إلى 2.5 مرة في هذا الوضع. إن سرعة الإخراج وانخفاض السعر لكل token أمران منفصلان عن التكلفة النهائية لإكمال المهمة.
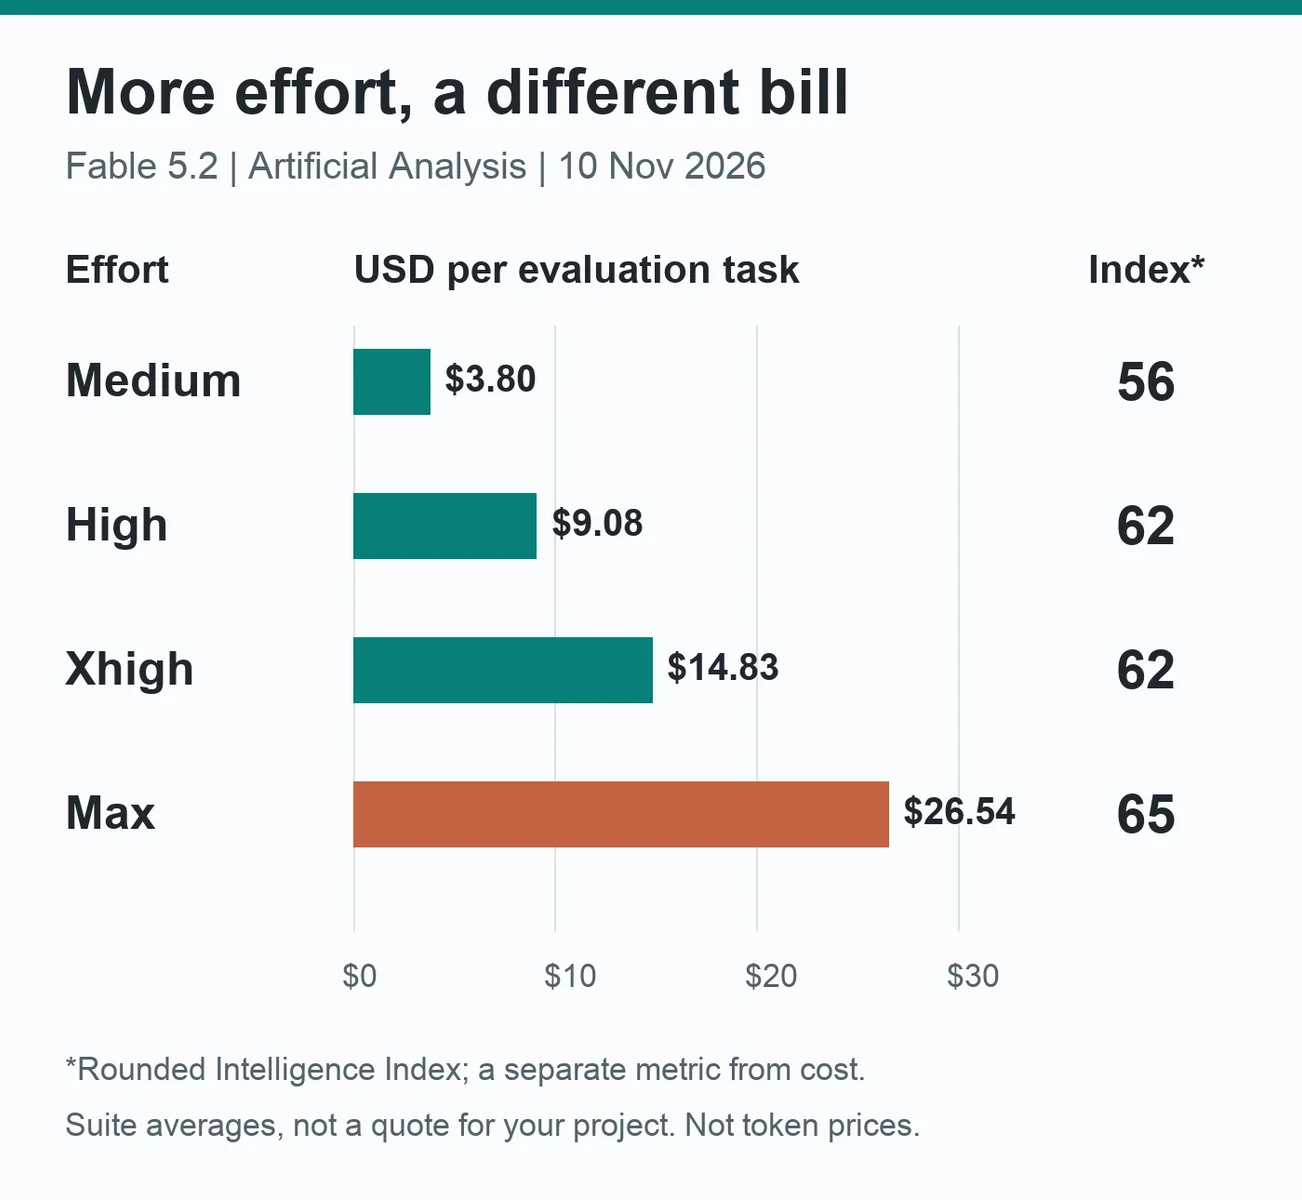
لقطة Artificial Analysis في 10 نوفمبر: medium بسعر 3.80 دولارات، وhigh بسعر 9.08 دولارات، وxhigh بسعر 14.83 دولاراً، وmax بسعر 26.54 دولاراً لكل مهمة في Intelligence Index. هذه متوسطات لمجموعة التقييم، وليست عروض أسعار لميزة أو مشروع بحثي. درجات المؤشر المقربة هي 56 و62 و62 و65 على التوالي. Artificial Analysis: مقارنة الجهد والتكلفة
يحتاج الجهد الأعلى إلى سبب
تضبط Anthropic واجهة API افتراضياً على high لـ Fable 5.2، بينما تقول صفحة الإطلاق إن تطبيقات Claude وClaude Code تستخدم medium افتراضياً. التفكير مفعّل دائماً. ويتحكم إعداد الجهد في مقدار العمل الذي يضعه النموذج في استجابته؛ وليس مجرد مفتاح لإجابات أطول.
يوصي دليل الجهد من Anthropic باستخدام high كنقطة بداية في API، وحجز max للمهام النادرة التي يكون فيها الوقت وtokens أقل أهمية. سأقارن الإعدادات على أعمال تمثيلية، ثم أدفع المزيد فقط عندما تبرر النتيجة ذلك. إرشادات جهد Claude
كيف سأرتب جلسة برمجة معقدة
ستكون نقطة بدايتي نتيجة واضحة وطلباً لفحص النظام الحالي. وسأريد أربعة أشياء من الجلسة:
قد يكون prompt البداية كالتالي:
text قبل التعديل، تتبع هذه الميزة عبر قاعدة الشيفرة الحالية. ارسم تبعياتها واشرح حالات الفشل الرئيسية. اقترح أصغر تغيير مكتمل والاختبارات التي ستكشف عن تنفيذ معطوب. حافظ على العمل غير المرتبط. اطلب الإذن قبل عمليات الترحيل أو النشر أو الإطلاق. بعد ذلك، أبلغ عما تغير، وما تحققت منه، وما لم يتم التحقق منه بعد.
لن أنسخ prompts تمنح النموذج ملكية غير مقيدة لقاعدة شيفرة خاصة بعميل. يحذر دليل prompting من Anthropic من أن صياغة الملكية قد تشجع على تغييرات إضافية، حتى عندما تحد تعليمات أخرى النطاق. وهذا سبب لجعل الحدود واضحة وفحص الفرق. Prompting Claude Fable 5.2
يمكن لنموذج أرخص أيضاً التعامل مع الخطوات الروتينية بينما يساعد Fable في القرارات الصعبة. وتدعم أداة advisor في Claude Code هذا الترتيب، مع شروط تتعلق بالوصول والفوترة. ولا تزال النصيحة تستهلك tokens؛ فالتفويض ليس مجانياً. وثائق Claude Code advisor
رأيي: استخدمه حيث يكون فهم النظام مهماً
أهتم بـ Fable 5.2 لأن التخطيط والبحث والتغييرات العابرة لقاعدة الشيفرة هي بالفعل الأسباب التي تدفعني إلى استخدام Fable. أريد مساعدة في ربط الأجزاء وتحدي النهج قبل أن أقضي وقتاً في تنفيذه.
لكن هذا لا يجعله خياري التلقائي لكل تعديل. لا تزال Anthropic توصي ببدء معظم أعمال البرمجة والمعرفة باستخدام Opus 5.5. يقدم استعراضي لـ Opus 5.5 ومراجعتي السابقة لـ Fable 5.1 سياقاً لهذا الاختيار.
في الأعمال الصعبة، أريد خطة واضحة، وتنفيذاً متماسكاً، ودليلاً على أنه يعمل. وسأبقي على عمليات التحقق المستقلة الموضحة في سير عمل مراجعة الشيفرة متعددة الوكلاء، بدلاً من اعتبار النموذج الأقوى مراجعاً نهائياً بحد ذاته.
يبدو Fable 5.2 جديراً بالاختبار في تلك المهام الأصعب. والسؤال المفيد هو ما إذا كان سيتركني مع عمل ناقص أقل ونتيجة يمكنني التحقق منها.